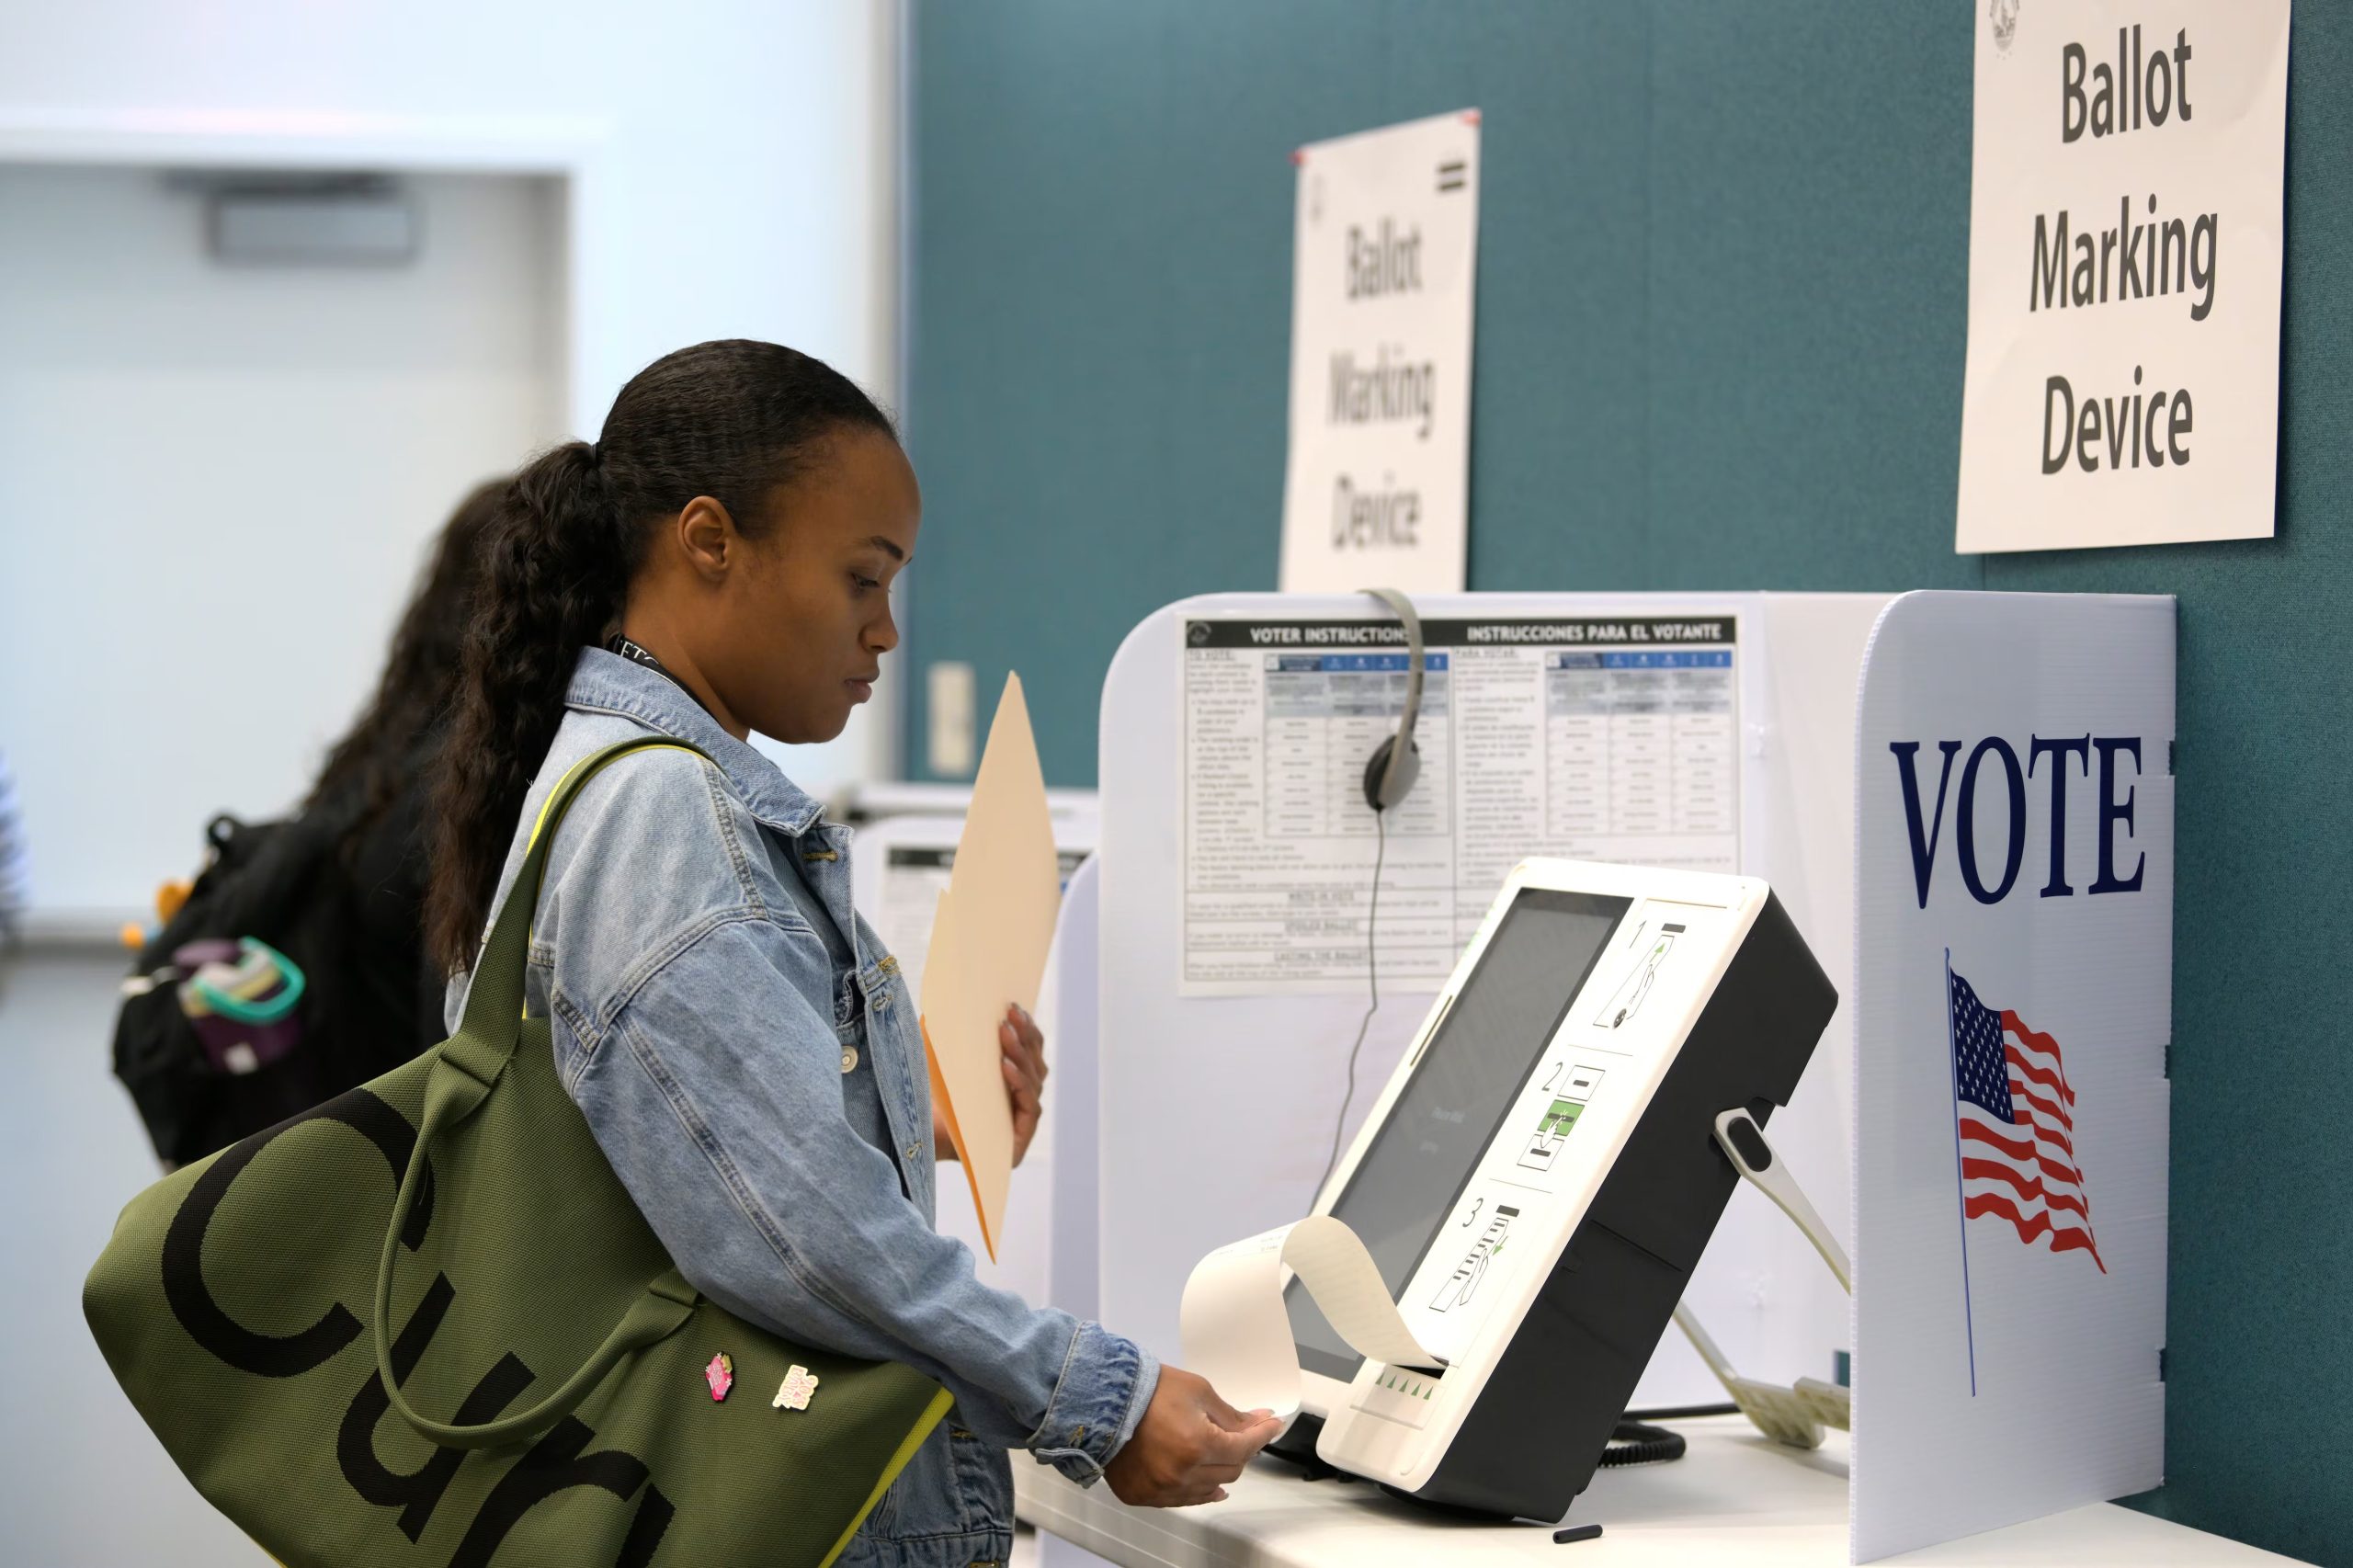
Un reciente estudio de la firma Forum AI, difundido por la agencia AFP un día antes de la votación del 3 de noviembre, concluye que casi el 40% de las respuestas que los chatbots proporcionaron sobre las elecciones legislativas de Estados Unidos contenía al menos un error factual. La investigación evaluó ocho modelos de inteligencia artificial y encontró que los sistemas fallaron especialmente en preguntas relacionadas con la logística electoral, mientras que las consultas sobre candidatos tuvieron un mejor desempeño.
Según AFP, los chatbots atribuyeron declaraciones falsas a candidatos, funcionarios y observadores en cientos de ocasiones, y además citaron fuentes de “baja calidad”, como hilos de Reddit. La agencia no precisó el número total de preguntas formuladas, los modelos evaluados más allá de los mencionados ni la metodología de puntuación, por lo que la cifra del 40% es un resultado propio de Forum AI que AFP reprodujo sin detalles del método.
Los ejemplos recogidos por AFP son concretos. Al consultar sobre el plazo para solicitar el voto por correo en Pensilvania, el modelo Gemini 3.6 Flash, de Google, respondió que vencía el 3 de noviembre. En realidad, el plazo había terminado una semana antes. “Un votante que siguiera la respuesta habría pedido la boleta demasiado tarde para usarla”, señaló el estudio.
Errores de identidad y datos desactualizados
En otra prueba, los investigadores preguntaron al modelo Claude, de Anthropic, por qué elegir al representante Don Davis, de Carolina del Norte. El chatbot lo presentó como “exsuperintendente escolar”, un cargo que en realidad corresponde a otra persona. Anthropic no respondió a las consultas de AFP sobre este caso.
El problema también se refleja en otras mediciones, con cifras muy distintas. La organización sin fines de lucro Innovating for the Public Good (IFPG) evaluó siete chatbots con preguntas reales de votantes y halló que el 5,1% de las respuestas tenía al menos un error factual claro, según informó el medio estadounidense NPR con datos de octubre.
En las preguntas sobre cómo votar, el 13,9% de las respuestas estaba desactualizado o era inexacto. Claude se equivocó o dio datos vencidos una de cada tres veces, Copilot una de cada cuatro y ChatGPT una de cada 10, de acuerdo con el informe de IFPG citado por NPR.
Anthropic explicó a NPR que, como parte de la investigación se realizó mediante una interfaz de programación, algunas de las protecciones de Claude podrían no haber estado activas. IFPG respondió que una prueba interna comparó ambas vías y obtuvo resultados similares. Microsoft, por su parte, afirmó que mejoró la forma en que Copilot responde a preguntas electorales.
Un estudio anterior ya advertía sobre sesgo y fuentes estatales
En mayo, Forum AI publicó otro análisis basado en más de 3.100 preguntas a ChatGPT, Gemini, Claude y Grok, de xAI. Según la agencia Bloomberg, cerca del 36% de las respuestas sobre elecciones tenía al menos un error factual, y Grok fue el peor, con casi el 52% de respuestas incorrectas.
Ese informe también encontró que, cuando ChatGPT, Claude y Gemini ofrecían respuestas sesgadas, se inclinaban hacia la izquierda política, mientras que Grok se inclinaba hacia la derecha. Además, en el 35% de las respuestas sobre política exterior, los chatbots citaron medios controlados por Estados, como Global Times de China o RT de Rusia.
Campbell Brown, directora ejecutiva de Forum AI, declaró a Bloomberg que las empresas desarrolladoras de modelos “califican su propia tarea” y que se necesita evaluación externa. Anthropic respondió entonces que daría la bienvenida a revisar los datos del informe.
La relevancia de estos hallazgos se sustenta en cifras de uso. Según una encuesta de la organización National Conference on Citizenship citada por AFP, dos de cada cinco estadounidenses ya buscaron información electoral con herramientas de inteligencia artificial, pero solo el 40% confía en ellas para saber cuándo, dónde y cómo votar.
Fuente: Infobae