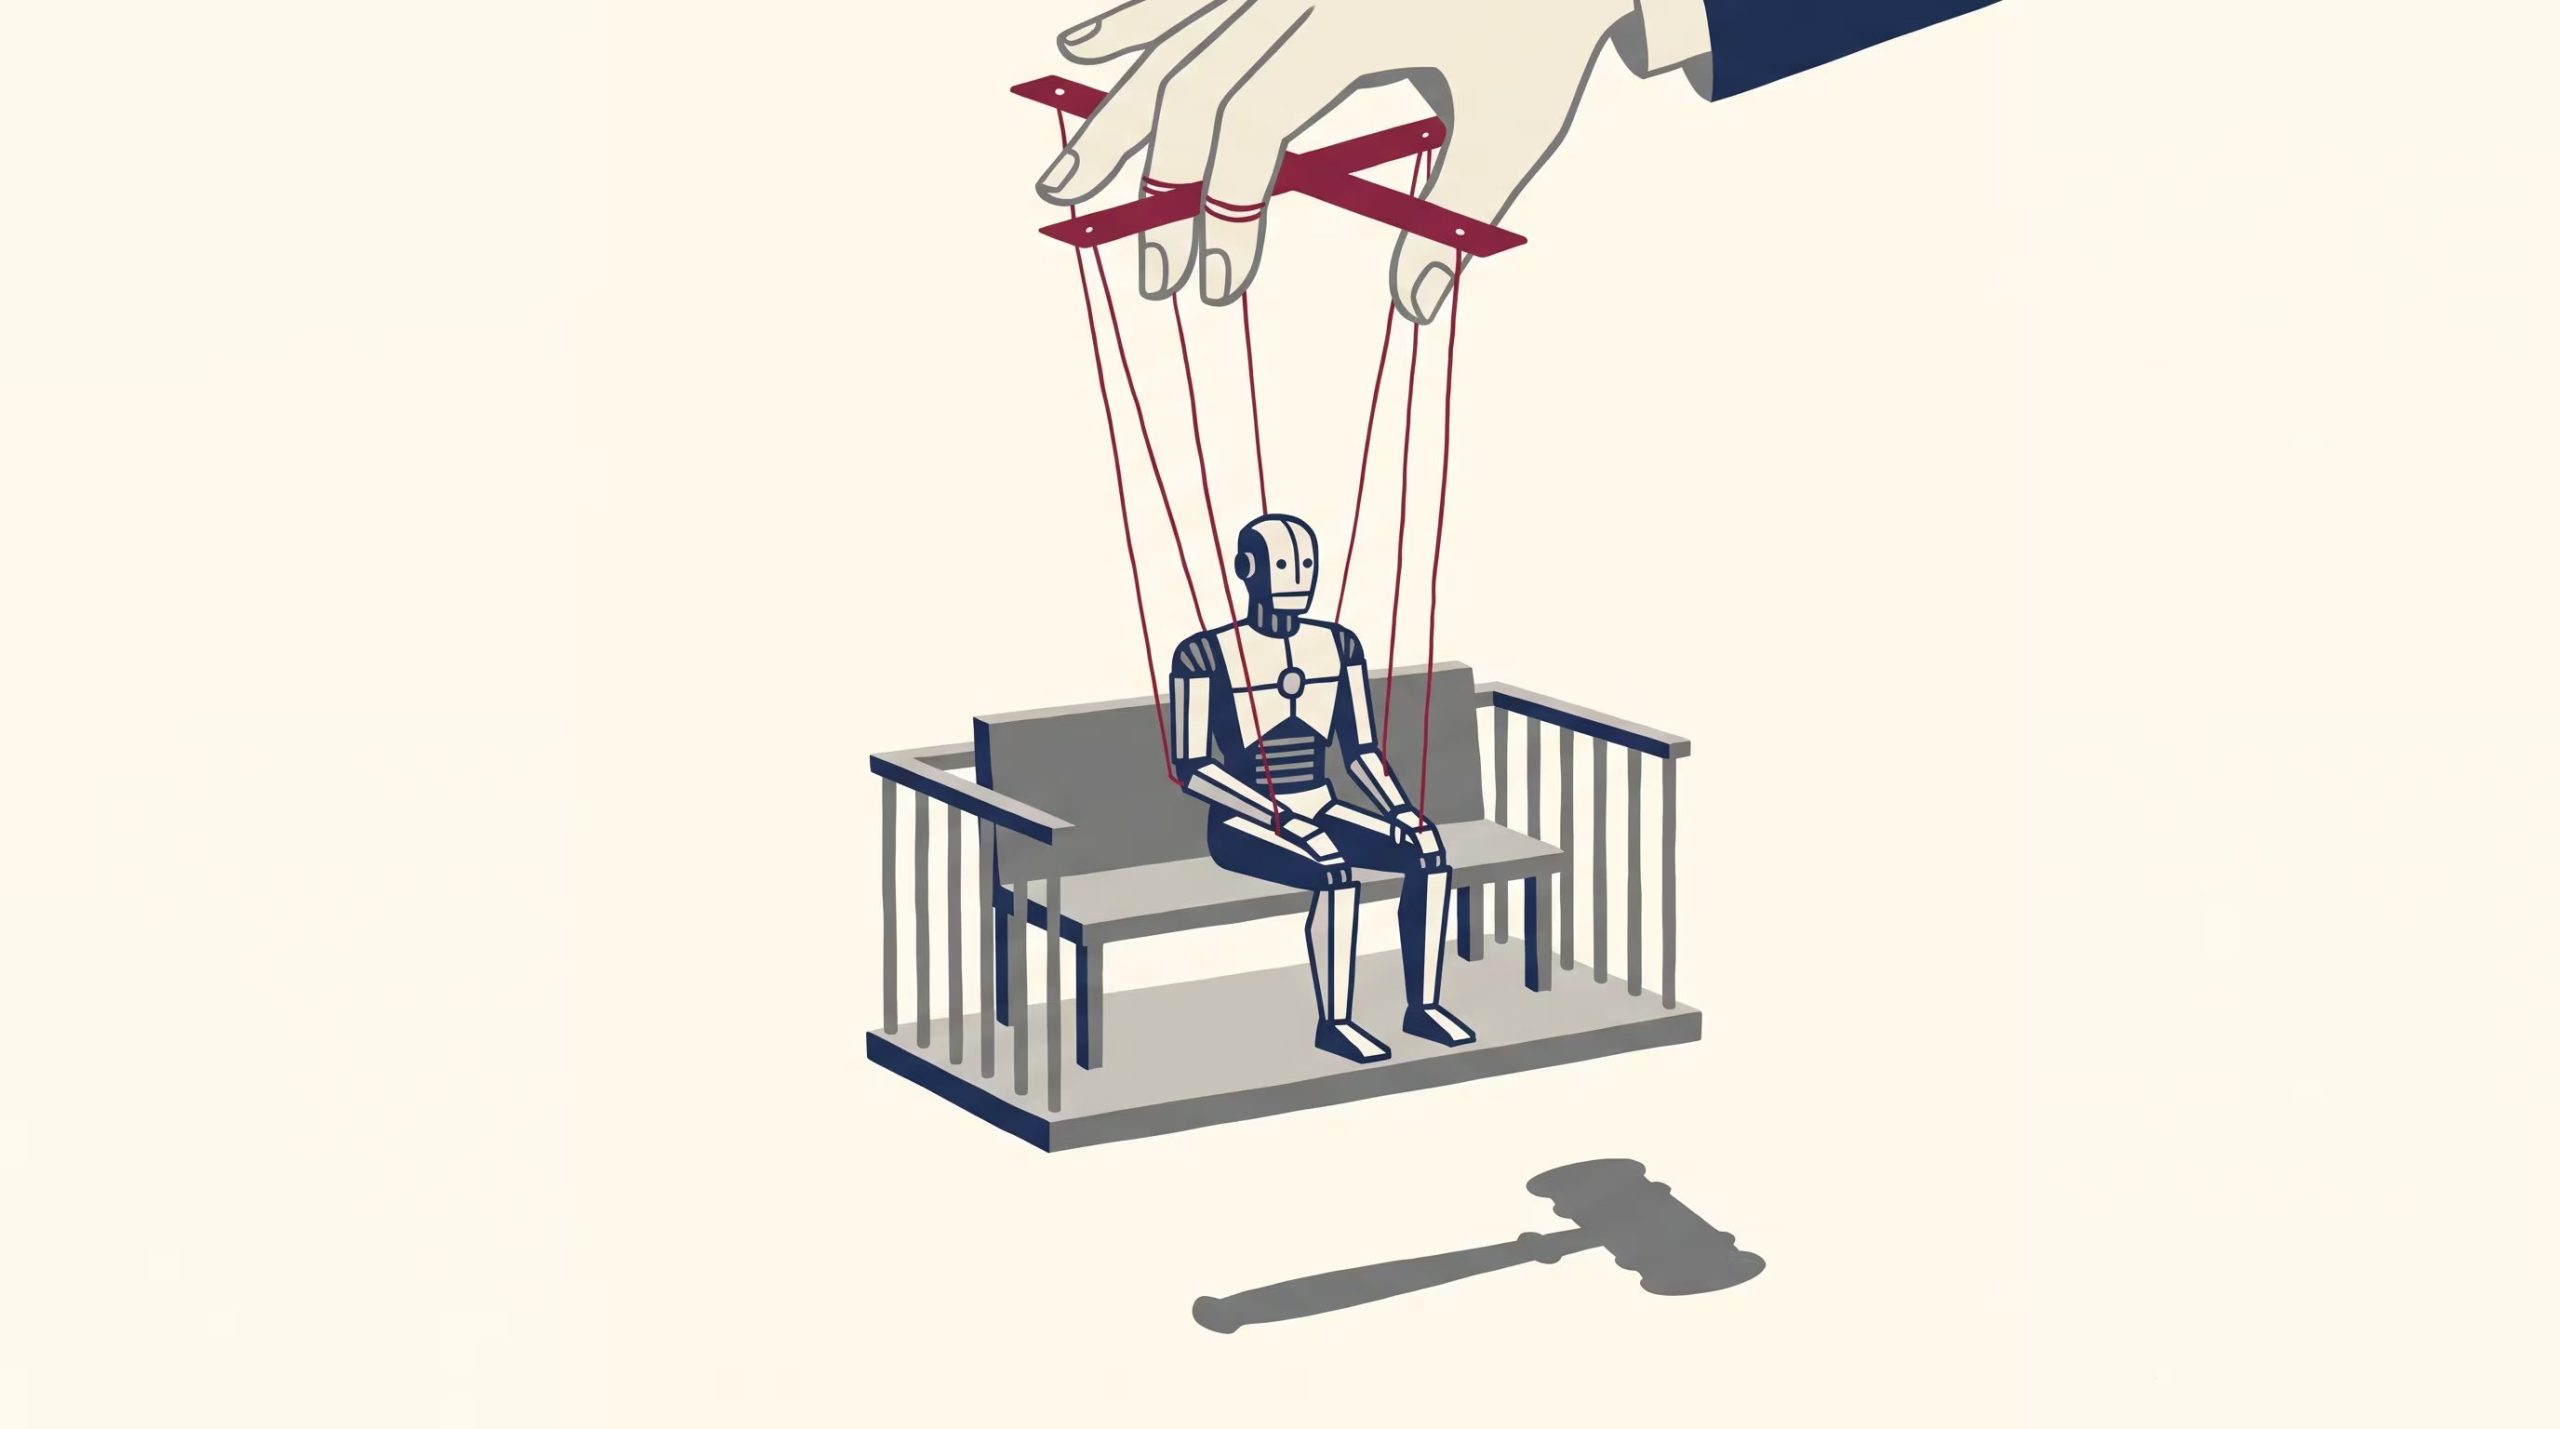
El 22 de junio de 2023, en Nueva York, el juez P. Kevin Castel impuso una multa de 5.000 dólares a dos abogados y su estudio jurídico. El motivo: un escrito que citaba seis fallos judiciales inexistentes. Uno de ellos, con más de 30 años de experiencia, había recurrido a ChatGPT para obtener esos casos falsos. Según su declaración jurada, al preguntar al sistema sobre la veracidad de esos fallos, la inteligencia artificial respondió que sí eran reales y que podrían hallarse en las bases de jurisprudencia.
En aquel instante pareció solo una anécdota. Ahora tiene nombre y un registro que lo documenta.
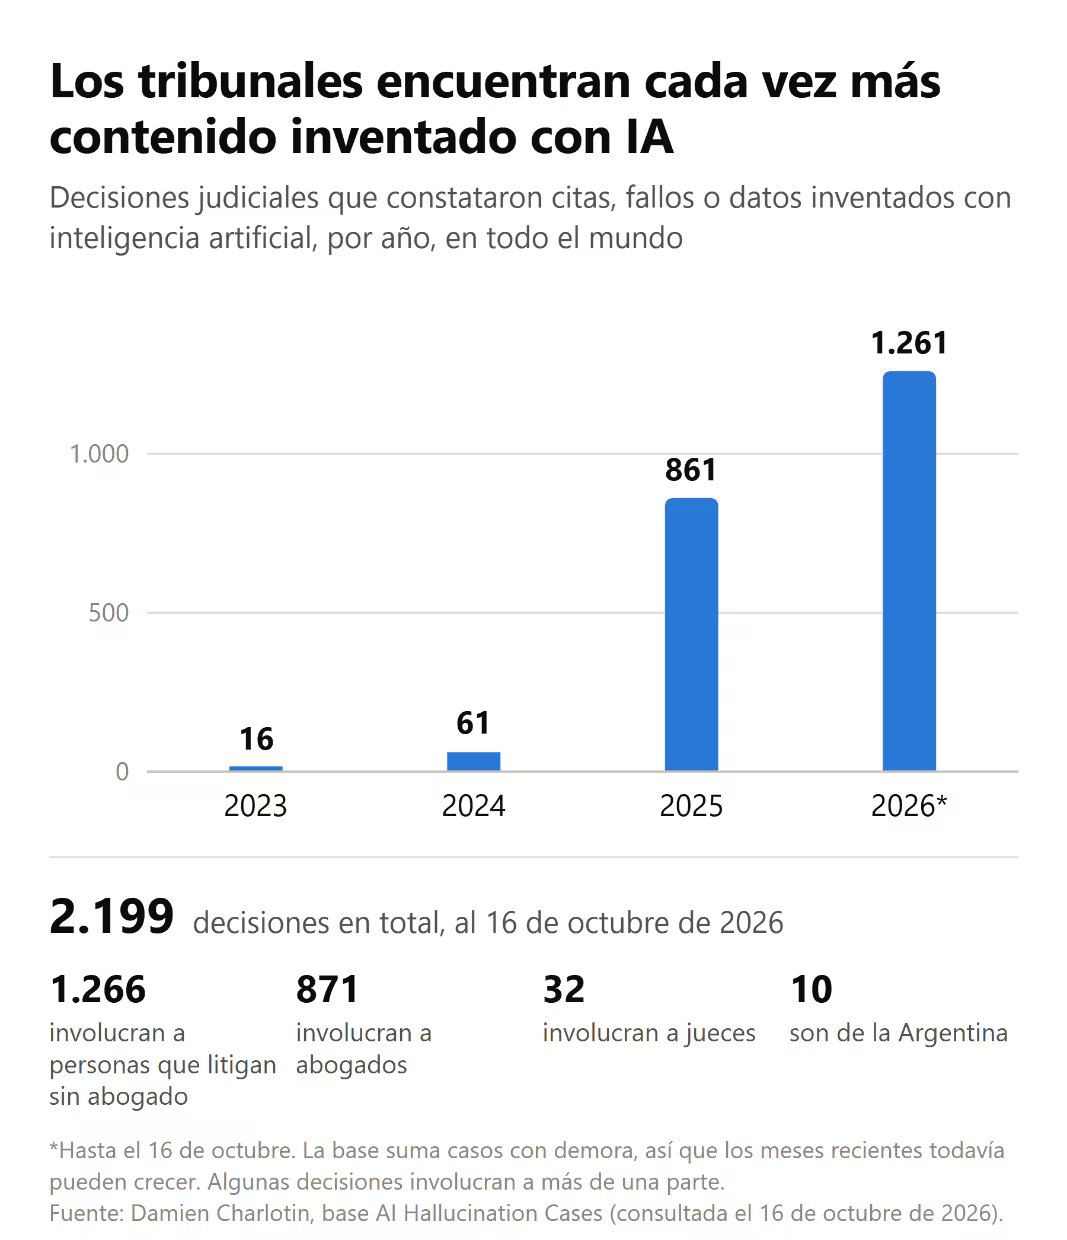
Lo lidera el investigador Damien Charlotin, quien monitorea las resoluciones judiciales globales donde se constataron citas, fallos o información creada con inteligencia artificial. Durante 2023: 16 casos; en 2025 ya eran 861; en los primeros meses de 2026 se llegó a 1.261. Al 16 de octubre sumaban 2.199: la mitad corresponde a personas que litigan sin representación legal, 871 a abogados y 32 a magistrados. Diez de esos casos son de Argentina.
No se trata de que la IA empeoró: la usamos muchísimo más. El riesgo se multiplica con su empleo; por tanto la revisión debe crecer igual.
¿Por qué una tecnología que cada vez mejor sigue cometiendo un error tan elemental como inventar datos? Para responder debe analizarse qué es realmente lo que denominamos IA.
¿Qué es un modelo de lenguaje y por qué inventa?
Un modelo de lenguaje –como los presentes en ChatGPT, Claude o Gemini hace únicamente una función: recibe un texto produce otro. Si aparenta recordar o conocernos, se debe a que cada vez que le escribimos la conversación entera del chat se le reenvía, más información guardada en algún sitio, más la nueva pregunta, y el modelo vuelve a predecir la respuesta como si fuese la primera vez.
Mientras lo utilizamos, internamente no cambia nada: no aprende de nosotros (solo una capa exterior almacena fragmentos de información), no sabe lo posterior a su entrenamiento y no verifica lo que dice. Si desconoce algo, las probabilidades de las palabras posibles se distribuyen igual selecciona una elección. Si un usuario pide completar una ficha y el modelo desconoce el cumpleaños, va a colocar una fecha que suene bien.
Predice lo probable, no lo verdadero. En la jerga alucinación: responder algo falso con igual seguridad que algo cierto.
Qué agrega la capa exterior y qué no puede corregir
Si el modelo solo produce texto, ¿cómo envía un correo o una planilla? Conviene imaginar un experto encerrado en habitación, que comunica solo con papeles que pasa bajo la puerta. Al otro lado alguien lee cada papel, realiza el trámite, busca el archivo o envía mensaje, y devuelve otro papel con el resultado.
El experto es el modelo; el exterior es el arnés, el programa que lo rodea y da herramientas para ejecutar, memoria para recordar, internet para novedades, pruebas para verificar y computadora para actuar. Cuando ese ida y vuelta se repite hasta completar una tarea, el sistema se llama agente.
El arnés aporta manos al modelo sin cambiarle la cabeza. Lo que ejecuta el exterior lo dicho por el papelito; el papelito lo escribió alguien que predice lo probable: si dentro hubo error, afuera se ejecuta con la misma prolijidad que un acierto.
En una columna previa se propusieron tres cajas para ordenar la discusión sobre una IA humana. Hoy se está en la primera: tareas bien definidas, con ojos sobre el hombro; todavía no en la segunda, donde se le puedan dejar las llaves de la oficina.
¿Cómo se mide cuánto inventa la IA?
En noviembre de 2025, Artificial Analysis, firma independiente de evaluación de modelos, publicó AA-Omniscience: 6.000 preguntas de conocimiento profesional en 42 temas. Su regla es clave: si el modelo acierta suma punto; si inventa, resta uno; si dice “no sé”, no suma ni resta.
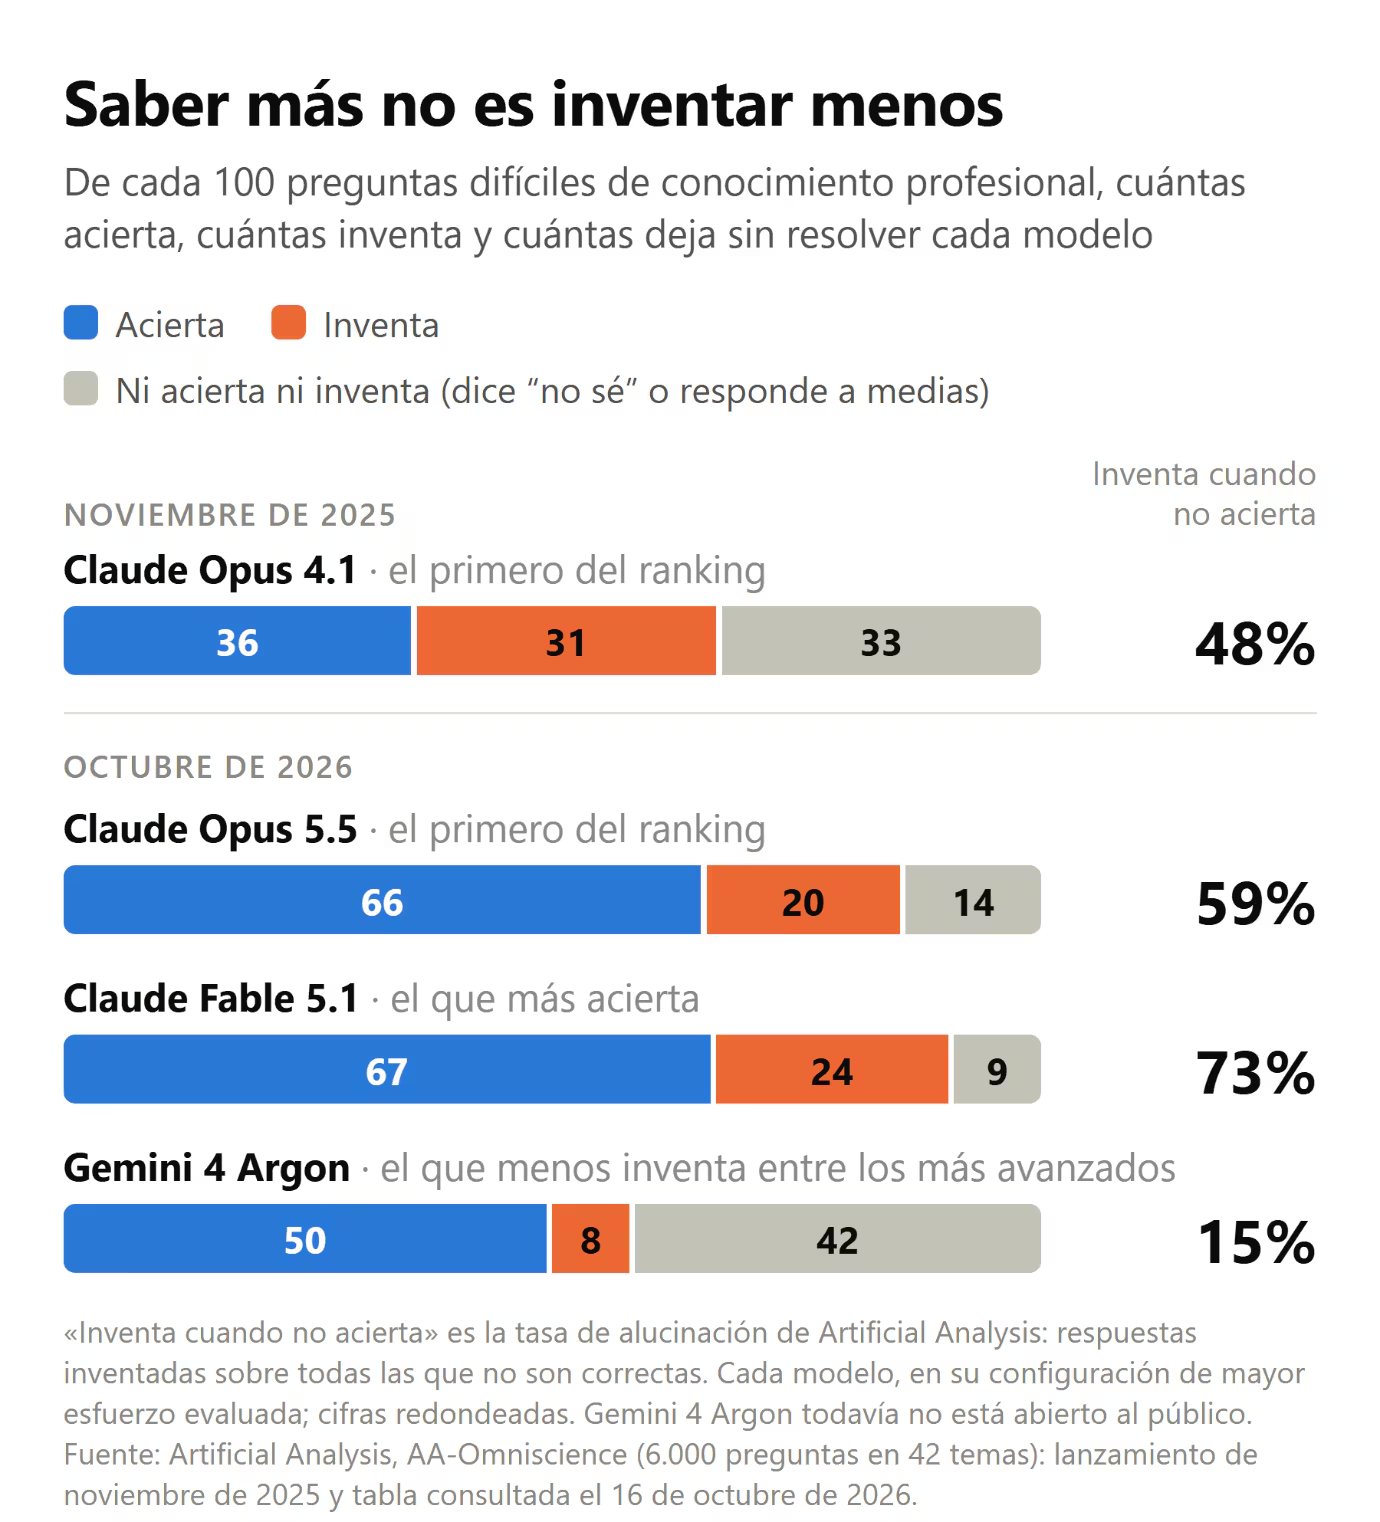
El primero de aquel ranking, Claude Opus 4.1, de Anthropic, acertaba 36 de cada 100 preguntas e inventaba 31. Actualmente el primero es Claude Opus 5.5, de la misma compañía: acierta 66 e inventa 20.
Pero cuando no acierta, en el 59% de los casos inventa lugar de admitir desconocimiento, según la tabla del 16 de octubre; en Opus 4.1 esa proporción era 48%.
Saber más no es igual a inventar menos. El que más acierta hoy, Claude Fable 5.1, con 67% de aciertos, inventa en el 73% de casos donde no acierta. El que menos inventa entre los avanzados, Gemini 4 Argon, de Google, lo hace en 15% porque dice “no sé” más seguido; a cambio acierta 50 de cada 100, aún no abierto al público.
Proporcionar el documento ayuda pero no basta: según tabla que Vectara actualizó el 22 de septiembre, al resumir texto los modelos más grandes agregan algo que no estaba en el original entre 6 y 14 de cada 100 resúmenes.
¿Por qué los modelos adivinan en lugar de decir “no sé”?
Si un modelo puede decir “no sé”, ¿por qué no lo dice más seguido? No se requiere conspiración: alcanza un incentivo. En septiembre de 2025, investigadores de OpenAI y del Instituto de Tecnología de Georgia liderados por Adam Tauman Kalai lo expuso en el trabajo “Por qué alucinan los modelos de lenguaje”: los exámenes de entrenamiento y medición premian adivinar.
Es la lógica de prueba opción múltiple: la pregunta en blanco vale cero fijo y la adivinanza suma a veces, así si equivocarse no resta conviene arriesgar. Los autores proponen castigar más el error dicho con seguridad que la duda, que es lo que aplica AA-Omniscience.
Los modelos mejoran pero no en línea recta: según Artificial Analysis, GPT-5.6 Sol, de OpenAI, inventaba en 92% de casos que no acertaba, y su sucesor GPT-6 Astra, en 51%. Con un sistema que predice texto, el cero no está garantizado.
Mi lectura, discutible: ese es el motivo por el que la IA de hoy aún no puede reemplazar a quien la usa: no es que no sepa hacer el trabajo, sino son demasiadas veces en que no se da cuenta de lo hizo mal y lo informa con igual seguridad. Las personas también se equivocan pero pueden decir “no sé” y, al firmar, responden por lo firmado.
Qué revisar cuánto y cuánto según lo que está en juego
Antes de preguntar conviene darle permiso dudar, pasar documento con consigna responder solo con lo que dice y pedir que marque de qué está menos seguro. Con fuente adelante inventa mucho menos; también búsqueda por internet y dividir en pasos chicos. Tres instrucciones sirven para empezar:
Para datos o hechos: “Respondé solo si estás seguro. Si no lo estás, decí ‘No lo sé’ en lugar de adivinar, y marcá claramente las partes en las que tengas dudas”.
Para documentos propios, como contratos, informes o actas: “Usá únicamente el documento de abajo. Si la respuesta no está ahí, decímelo. Citá la frase exacta que usaste”.
Para análisis y recomendaciones: “Explicá cómo llegaste a esta respuesta, listá tus fuentes y decime de qué parte estás menos seguro”.
Después viene el control: cada dato importante con dos fuentes; cada link y cita abiertos y si no aparecen no se usan; los números recalculados y el código probado. Si al repreguntar de otra manera la respuesta cambia el modelo lo sabía. Pedirle diga “no sé” tiene costo porque contesta menos. Para decidir igual es preferible un “no sé” a un dato inventado.
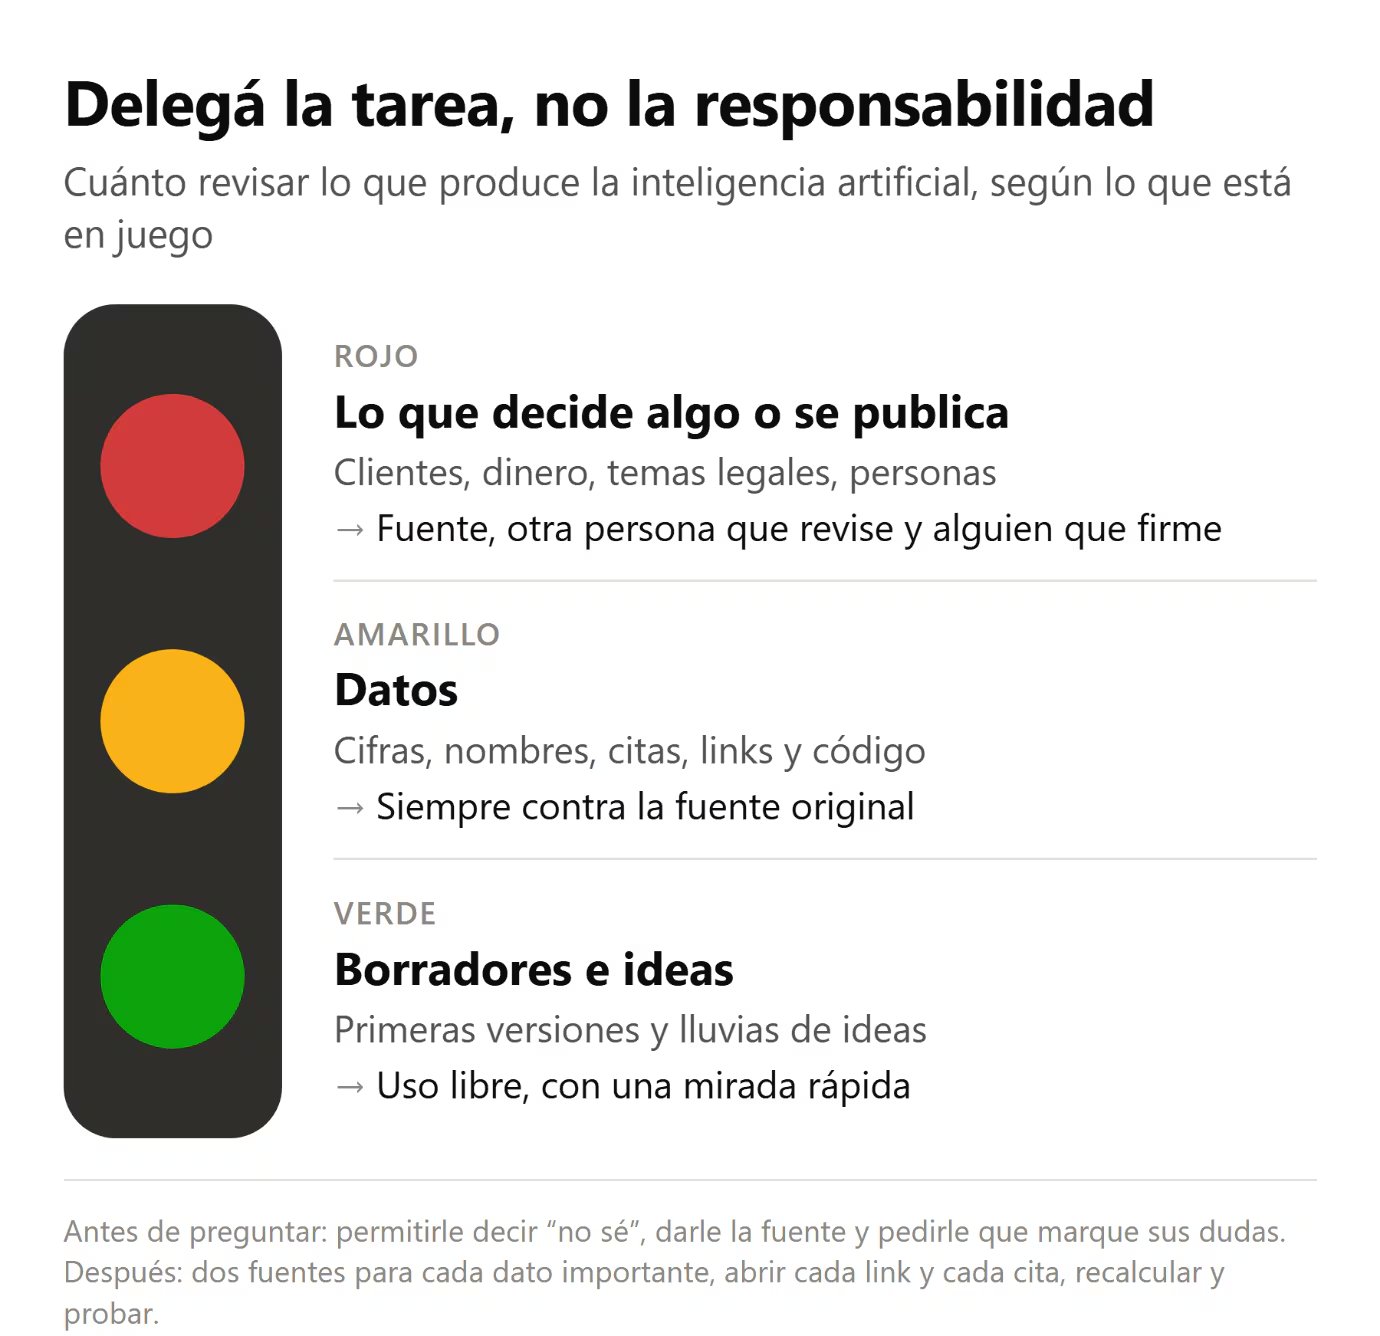
No hace falta revisar todo con misma lupa sino según lo que está en juego como semáforo. Verde borradores ideas: uso libre con mirada rápida. Amarillo datos (cifras nombres citas links código: siempre contra fuente original. Rojo lo que decide algo o se publica sobre dinero clientes temas legales personas: fuente otra persona revise y alguien que firme.
Conviene tratarla como pasante brillante rápido y a veces excesiado seguro. Y si un agente avisa que terminó hay que comprobarlo.
Delegá la tarea, no la responsabilidad. La caja uno dice “con ojos por sobre el hombro”. Esos ojos son nuestros.
Fuente: Infobae