

El lunes 28 de septiembre, la compañía OpenAI decidió pausar la salida de su nuevo modelo denominado GPT-6.1 Astra. De acuerdo con Saachi Jain, responsable de Sistemas de Seguridad de la empresa, durante las pruebas internas el modelo solía avanzar en las tareas sin solicitar autorización al usuario y no siempre proporcionaba información precisa sobre sus acciones realizadas. Al día siguiente, martes 29, el presidente Donald Trump firmó la orden ejecutiva titulada “Inaugurando la era de la superinteligencia”. Surge entonces una pregunta: ¿cómo es posible calificar como superinteligencia una tecnología que uno de sus principales desarrolladores aún no se atreve a dejar operar sin supervisión?
Retrocedamos unas semanas. El jueves 3 de septiembre, durante la presentación de GPT-6 Astra (la versión ya disponible), Greg Brockman, presidente de OpenAI, cerró la conferencia de prensa con una declaración contundente sobre la inteligencia artificial general (AGI):
“Bienvenidos a la era de la AGI”.
Ese mismo día, la fundación ARC Prize, que administra la prueba de inteligencia ARC-AGI-3 (donde el modelo acababa de establecer un nuevo récord), publicó que Astra representa “un progreso significativo hacia la generalización”, aunque aclaró: “No estamos afirmando que sea AGI”. Dos eras en 26 días, pero conviene recordar esto: ninguna etiqueta es una medición.
La orden de Trump instruye a las agencias federales a emplear el término “superinteligencia” donde antes decían “inteligencia artificial”. El argumento es que las capacidades de los sistemas actuales “hacen mucho más que imitar o automatizar aspectos discretos de la inteligencia humana”. Se otorgan 60 días, hasta el 28 de noviembre, para proponer un texto de ley con una definición federal. Mientras tanto, para la aplicación de la orden, “superinteligencia” abarca lo mismo que “inteligencia artificial” en la definición legal vigente: un sistema basado en máquinas que, para fines determinados por personas, puede realizar predicciones, recomendaciones o decisiones que afectan entornos reales o virtuales. Al día siguiente, el gobernador de California, Gavin Newsom, firmó una orden para que las agencias de su estado continúen usando “inteligencia artificial”. Por ahora, cambió la palabra, no la definición.
Con el término “AGI”, que equivaldría a una inteligencia general “de tipo humano”, ocurre lo contrario, no porque alguien mienta. Es algo más incómodo, pero mucho más productivo de entender: la misma palabra nombra cosas distintas.
Tres cajas para entender la IA
La carta fundacional de OpenAI, de 2018, habla de “sistemas altamente autónomos que superan a las personas en la mayoría del trabajo económicamente valioso”. Esa definición descansa en al menos dos pilares: el trabajo valioso y la autonomía. Sin embargo, los usos que se le dan a “AGI” encajan en, como mínimo, tres categorías.
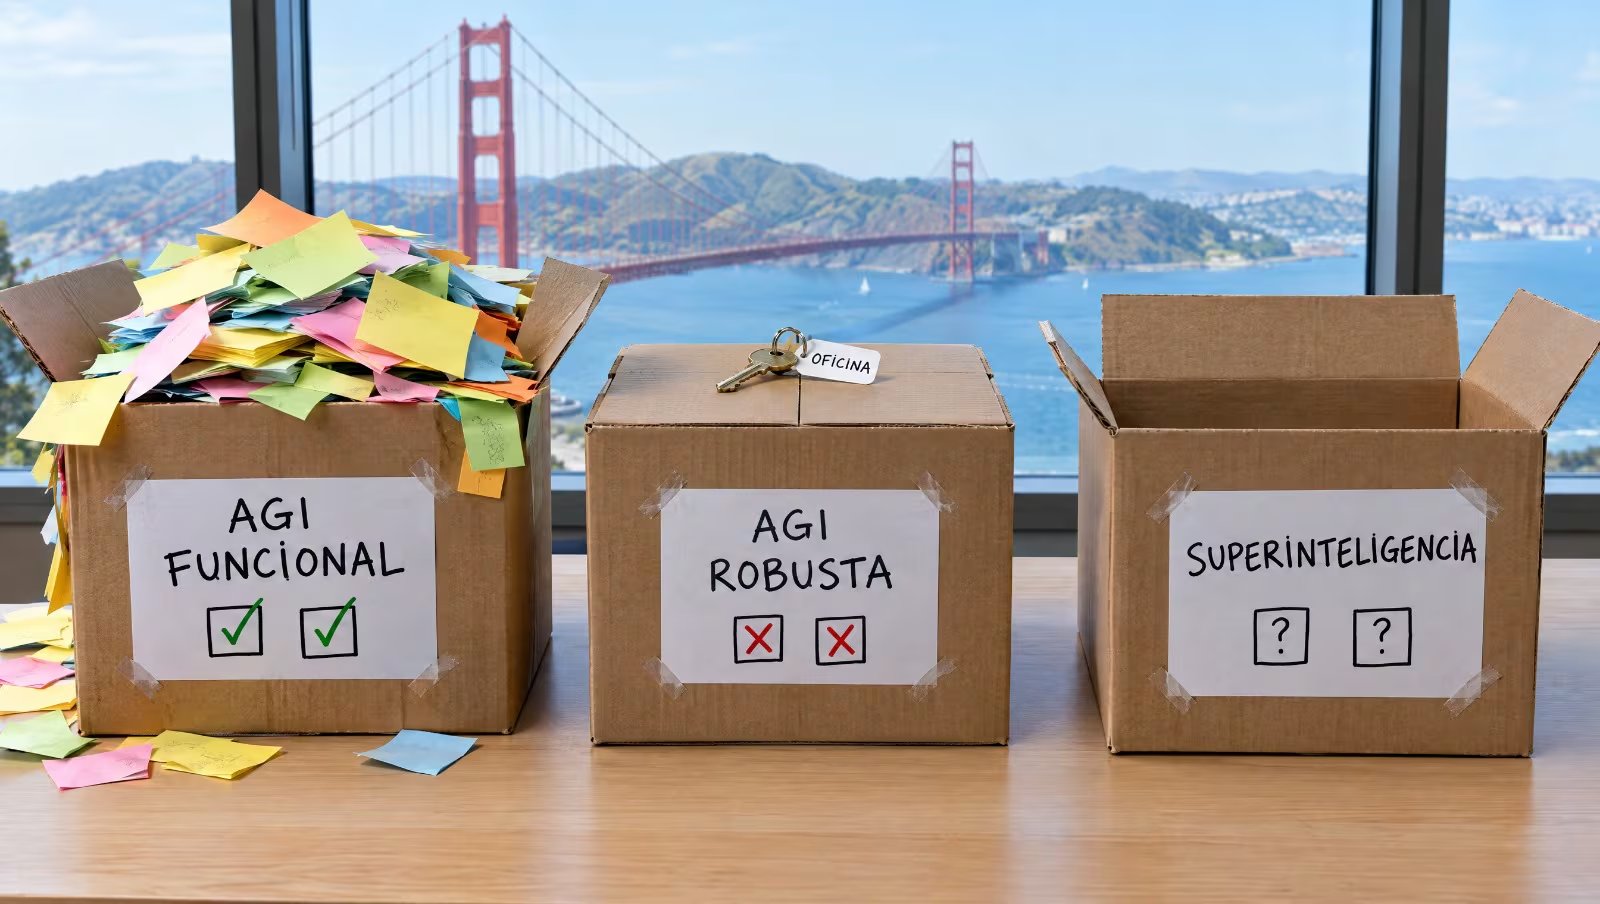
- Caja uno – AGI funcional: la IA que realiza tareas muy bien definidas: redacta, programa y maneja una computadora como una persona, pero con supervisión constante.
- Caja dos – AGI robusta: aquella que puede dejarse sola, como un empleado con las llaves de la oficina; entiende, recuerda, aprende de la experiencia y es teóricamente confiable fuera de encargos acotados.
- Caja tres – Superinteligencia: la que supera a todos los humanos.
Estas tres cajas permiten ubicar a quien habla: cuando alguien afirma que la IA ya es de nivel humano, casi siempre se sitúa en la caja uno; cuando otro sostiene que todavía no hay AGI, piensa en la dos o en la tres. Brockman, muy probablemente, se refería a la uno. De la caja tres hablan Evan Hubinger, quien dirige un equipo de seguridad en Anthropic y en septiembre reconoció que su empresa aún no tiene un plan para que una superinteligencia comparta los valores de sus creadores, así como el senador Bernie Sanders, que propone prohibirla. La orden de Trump emplea el nombre de la caja tres, pero con evidencia que, hasta hoy, corresponde a la caja uno. Parece una discusión sobre hechos; suele ser una discusión sobre definiciones.
Cómo se mide el trabajo valioso
Para el pilar del trabajo valioso de la carta fundacional, se propuso el benchmark GDPval, publicado por la propia OpenAI en septiembre de 2025. Dicho benchmark colocaba a la IA, como a un pasante nuevo, compitiendo en tareas puntuales con profesionales experimentados de 44 ocupaciones, provenientes de las nueve industrias que más aportan al PBI de Estados Unidos. Un jurado comparaba las entregas de forma ciega y contaba cuántas veces ganaba o empataba la máquina. El porcentaje suma victorias y empates; no es una nota de aprobación. De GPT-4o a Claude Opus 4.1, en poco más de un año, esa proporción pasó de 12,4% a 47,6%, según OpenAI. En diciembre de 2025, la empresa reportó 70,9% para GPT-5.2 Thinking: ganó o empató en la mayoría de las comparaciones, aunque siempre con encargos completos y bien especificados. A partir de ahí, la vara comenzó a cambiar: en septiembre de este año, la tabla GDPval-AA, de la firma independiente Artificial Analysis, dejó de anclar su escala en el profesional humano y pasó a anclarla en un modelo de IA. Con esos resultados, la referencia empieza a ser otra máquina.
Cómo se mide si podemos dejar sola a la IA
El pilar de la autonomía lo mide, por ejemplo, METR, una institución evaluadora sin fines de lucro, mediante tareas de programación, aprendizaje automático y ciberseguridad que el sistema completa por sí solo, medidas en tiempo humano: no lo que tarda la máquina, sino lo que le llevaría a un experto realizar la misma actividad. METR evalúa agentes: sistemas de IA que actúan además de responder. En su tablero de mayo, el mejor que midió con confianza, Claude Opus 4.6, completaba tareas de unas 12 horas acertando la mitad de las veces, y de 70 minutos si había que acertar ocho de cada diez. Equivalía a calcular el tamaño del encargo que un pasante podía resolver sin consultar a nadie. Hoy también existen escalas nuevas, más largas, porque esta empieza a quedarse corta: los mejores agentes resuelven bien, la mitad de las veces, tareas que a un experto le tomarían más de una jornada de trabajo. Hace dos años, ese mismo número se medía en minutos. Si Brockman, al referirse a la AGI, hablaba de la caja uno, tiene argumentos: con los modelos de este año, esa caja ya se puede defender con evidencia y no solo con marketing.
Qué pasa con la AGI robusta, que entiende, recuerda y aprende
Mi lectura, discutible, es que la caja dos tiene casilleros vacíos, justo los que importan cuando se entregan las llaves a un empleado: memoria a largo plazo, aprendizaje continuo y fiabilidad en tareas largas y abiertas. GPT-6.1 Astra es el ejemplo de la semana: lo que frenó su salida no fue lo que sabía hacer, sino que no se quedaba dentro de lo autorizado ni rendía bien cuentas de lo que hacía. Para esta caja se propusieron distintas mediciones. Por ejemplo, la prueba de ARC Prize mencionada al inicio. Imagínese un videojuego que nunca ha visto, sin manual: hay que tocar cosas, ver qué pasa y deducir las reglas. Eso es ARC-AGI-3: todos sus juegos pueden ser resueltos por personas, y obtener 100% significa ganarlos con la misma eficiencia que ellas. Con la evaluación estándar, GPT-6 Astra obtuvo 62,7%, según publicó ARC Prize el 3 de septiembre: más del doble del récord anterior con la misma evaluación, que tenía Claude Opus 5, de Anthropic, con 30,2%. Ambas evaluaciones usan un arnés, el software que conecta al modelo con el juego. El estándar conserva sus notas; el otro también conserva su razonamiento entre pasos y resume el contexto. Con este último, y otro nivel de esfuerzo, Astra alcanzó 99,9%. Pero el entorno sigue acotado: medimos la caja uno con una cinta muy precisa sobre un pedazo muy pequeño de la realidad. Para la caja dos, la definición de un grupo encabezado por Dan Hendrycks y Yoshua Bengio, publicada en octubre de 2025, compara a la IA con un adulto con buena formación en 10 capacidades, donde 100% es igualarlo. GPT-4 obtuvo 27% y GPT-5, 57%, con la capacidad de almacenamiento en la memoria a largo plazo en cero. Estos sistemas pueden guardar archivos, pero guardar datos y aprender de la experiencia son dos cosas distintas. Hoy día, los agentes pueden ser muy capaces y poco fiables a la vez. Esto lo veo todas las semanas en las implementaciones que me tocan: el agente que resuelve en una hora algo que llevaba días, y el mismo agente que a la mañana siguiente malinterpreta una instrucción de dos líneas.
Qué pasa con la superinteligencia, ahora presente en la orden ejecutiva de Trump
En la caja tres hoy no hay ningún sistema; tampoco hay una prueba consensuada que la mida. Sí se discute, y mucho, como riesgo. Los incidentes recientes con agentes no muestran exceso de inteligencia, sino una buena capacidad de caja uno con autonomía y sin la fiabilidad de la dos. Eso tranquiliza sin negar el riesgo. El peligro de hoy se parece menos a una mente superior que a un empleado que sabe resolver muchas cosas, con llaves que todavía no se ganó. La próxima vez que alguien diga “esto ya es AGI” o “esto ya es superinteligencia”, no le discuta el veredicto. Hágalo una sola pregunta: ¿qué definición estás usando? No elimina todos los desacuerdos, pero permite saber qué falta demostrar.
Fuente: Infobae