

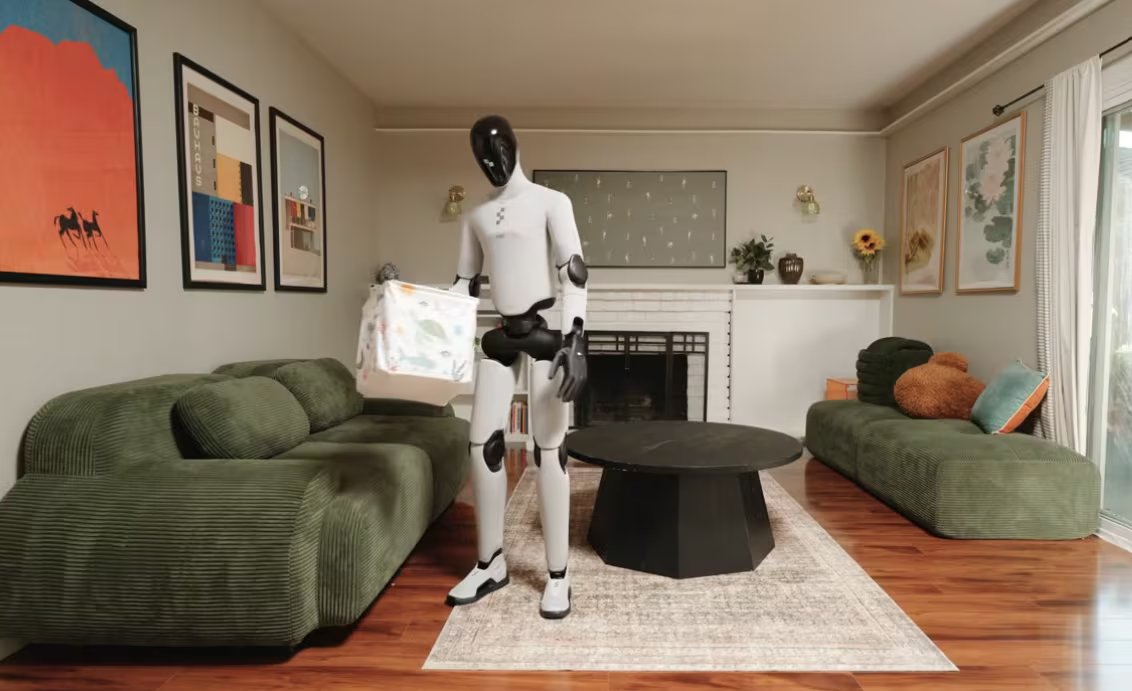
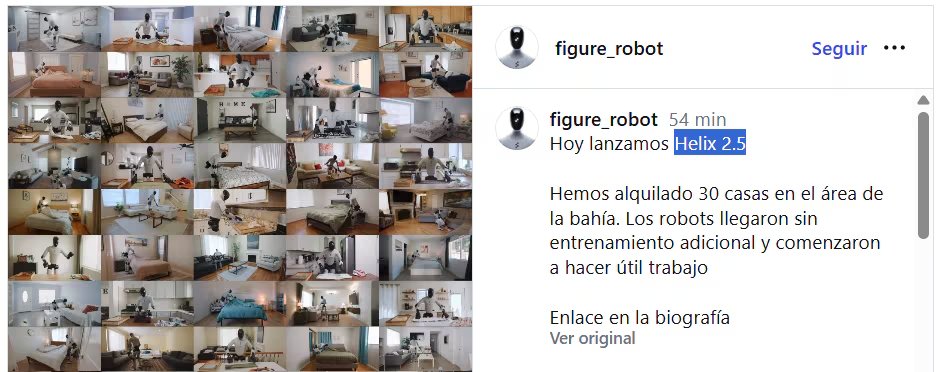
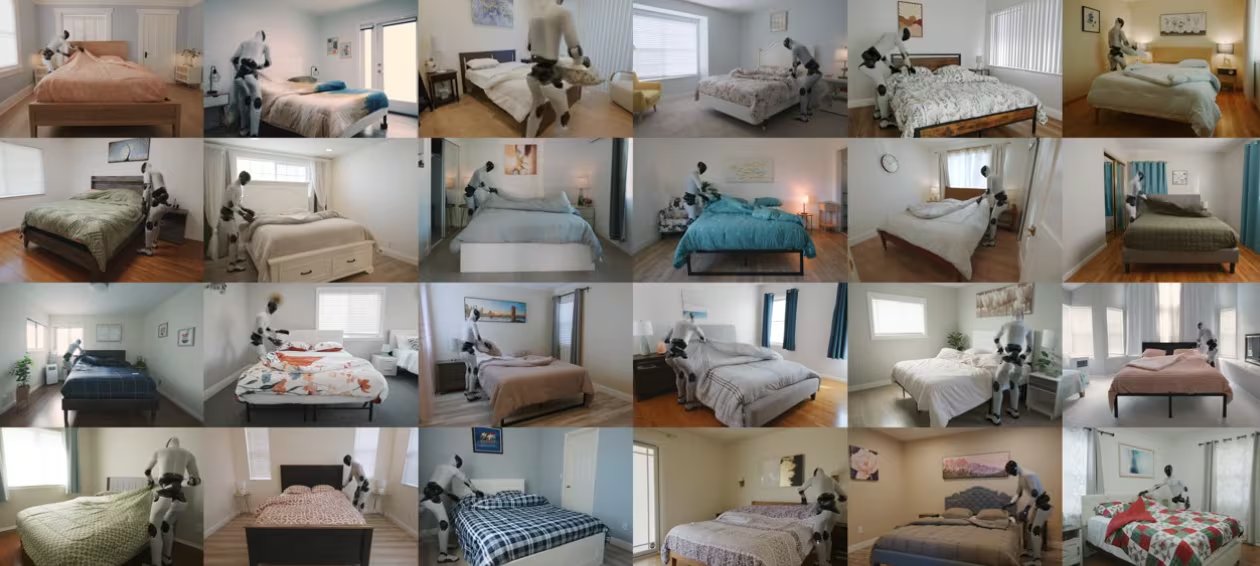
La empresa Figure presentó su nuevo sistema Helix 2.5, una red neuronal diseñada para robots humanoides. Este modelo fue preentrenado sobre Index, un conjunto propio de datos sobre comportamiento humano, y posteriormente evaluado en 30 hogares del Área de la Bahía donde no se había recopilado información previa.
En una comparación controlada frente a una política idéntica entrenada desde cero, el preentrenamiento en Index elevó la tasa de éxito zero-shot del 9% al 56%. A partir de ese único modelo base, Figure derivó tres comportamientos de cuerpo completo: ordenar salas de estar, doblar toallas y hacer camas.
El antecesor, Helix 02, ya coordinaba control de cuerpo completo en tareas largas como descargar un lavavajillas o ejecutar una operación logística autónoma durante 200 horas, pero dependía de datos del mismo entorno donde luego operaría.
Evaluación zero-shot en hogares sin datos previos
Figure definió el concepto de zero-shot tanto para los entornos como para los objetos manipulados. Cada comportamiento se especificó con datos de afinamiento recopilados en un lugar distinto al de la prueba.
Ningún juguete, toalla o ropa de cama utilizados en la evaluación había aparecido antes en los datos de especificación de tareas, y el robot trabajó sobre sofás, camas y superficies ya existentes en cada hogar.
Los objetos de evaluación se reservaron antes de iniciar los experimentos. Un modelo de inteligencia artificial, con revisión humana posterior, verificó que ninguno de esos objetos apareciera en los datos usados para especificar las tareas.
Cada tarea empleó un único punto de control fijo en los 30 hogares visitados. No hubo ajuste de pesos según el hogar o los objetos, y ningún dato de ejecución se usó para seleccionar ese punto de control. El criterio de éxito exigía completar la tarea entera, sin crédito parcial, y cualquier intervención humana por seguridad marcaba la ejecución como fallida.
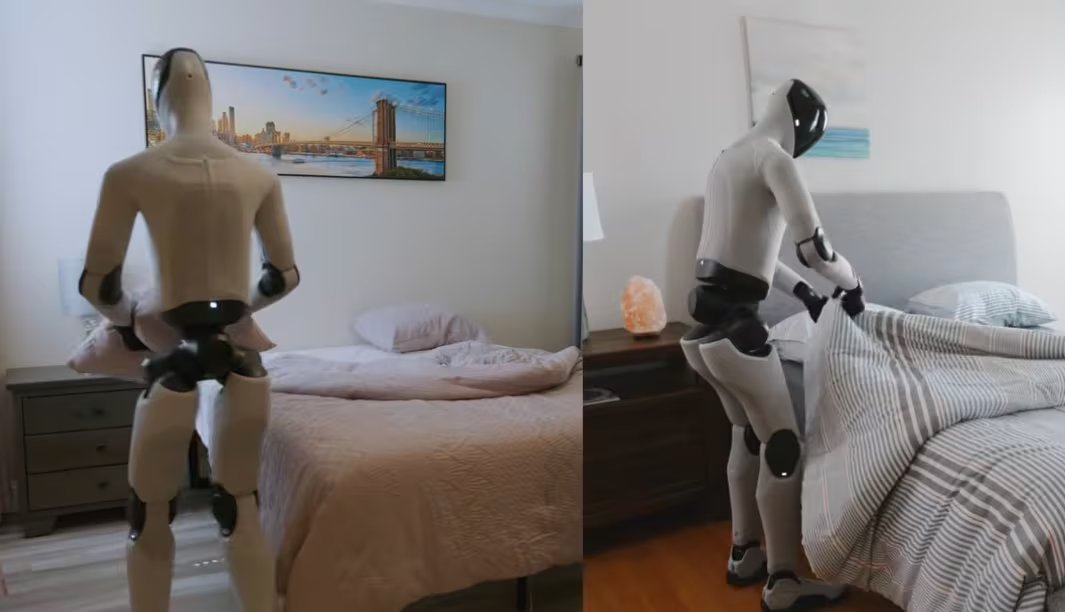
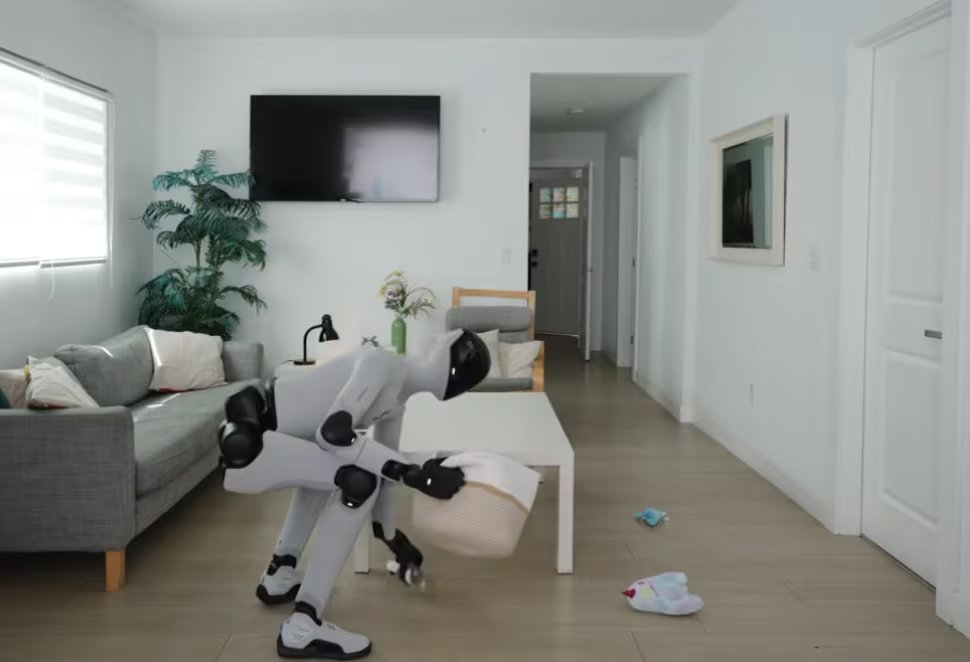
Las rúbricas de calificación se fijaron antes de comenzar. En Ordenar la Sala de Estar, el robot debía recoger entre 13 y 15 juguetes dispersos y colocarlos en una cesta, con un máximo de un minuto por juguete. En Doblar Toallas, cada pieza debía quedar doblada con las cuatro esquinas casi tocándose dentro de una pulgada, en un máximo de tres minutos por toalla.
En Hacer la Cama, tanto las almohadas como ambas esquinas del edredón debían alcanzar el tercio superior de la cama con la tela estirada de forma lisa, con un límite de un minuto por almohada y por lado del edredón.
El experimento que aísla el efecto real del preentrenamiento en Index
Para determinar cuánto del resultado provenía específicamente de Index y no de los datos de especificación de tareas, la compañía entrenó dos políticas con datos idénticos: una inicializada con pesos aleatorios y otra desde el modelo Helix 2.5 ya preentrenado en Index.
La arquitectura, optimización, hiperparámetros y evaluación se mantuvieron fijos; el preentrenamiento fue la única variable experimental.
Helix 2.5 se entrenó por completo desde una inicialización aleatoria en Index, a diferencia de Helix 02 que partió de un modelo de visión-lenguaje ya preentrenado. En evaluaciones a ciegas, la política desde cero logró éxito en el 9% de los ensayos zero-shot, mientras que la preentrenada en Index alcanzó el 56% —una diferencia que la empresa describió como más de seis veces mayor.
Este preentrenamiento en la generalización de tareas de cuerpo completo a esa escala en un robot humanoide fue definido por Figure, según su propio conocimiento, como la primera demostración de este tipo.
La empresa precisó además que ninguna tarea de evaluación individual representa más del 1,90% del conjunto total de datos de preentrenamiento de Index, lo que descarta que el resultado dependa de una sobrerrepresentación puntual.
Menos datos, mejor autocorrección: la eficiencia de Helix 2.5
Figure comparó también Helix 2.5 con una política anterior de Helix 02 entrenada para la misma tarea, pero con datos recopilados directamente en el entorno donde luego se evaluó. Según la empresa, Helix 2.5 igualó esa tasa de éxito utilizando la mitad de los datos de adaptación, y lo hizo de forma zero-shot en 30 hogares nunca antes vistos.
La compañía reportó además una mejora cualitativa en la capacidad de autocorrección de cuerpo completo: el robot retrocedía para reposicionarse, cambiaba de postura o se movía alrededor de una cama completa para corregir un pliegue mal hecho. Figure calificó este comportamiento como uno de los efectos más importantes derivados del preentrenamiento en Index.
Una ley de escalado que predijo resultados con cuatro decimales de precisión
En un experimento aparte, la organización entrenó cuatro modelos sobre subconjuntos anidados de Index que abarcaban un aumento de 8 veces en el volumen de datos de preentrenamiento, manteniendo fijos el tamaño del modelo y el entrenamiento posterior. La pérdida de predicción de acción retenida disminuyó de forma predecible con cada duplicación de los datos de Index utilizados.
La compañía usó únicamente los resultados de las corridas más pequeñas para predecir, con cuatro decimales de precisión, la pérdida de prueba de la corrida más grande antes de que comenzara su entrenamiento. El error de ese pronóstico equivalió al 0,54% de la variación observada en todo el rango de datos de 8 veces.
Figure describió este hallazgo como, según su propio conocimiento, la primera ley de escalado de transferencia humano-a-robot medida en un sistema humanoide. La compañía aclaró que el resultado mide exclusivamente el escalado de datos, sin extender esa conclusión a otras variables del entrenamiento.
Fuente: Infobae