Imagina un estadio repleto, una pelota suspendida en el aire y todas las miradas fijas en el bateador listo para golpear. Esta escena, cargada de simbolismo, puede ser reconstruida por un modelo de inteligencia artificial llamado Brain-IT a partir de la simple actividad cerebral de una persona que la observa. Desarrollado en el laboratorio de la profesora Michal Irani del Instituto Weizmann de Ciencias, Brain-IT ha aprendido a identificar patrones neuronales que se repiten en distintas personas mientras procesan imágenes, permitiéndole leer la mente de nuevos individuos con una velocidad sin precedentes y una precisión asombrosa.
En la última década, los científicos han logrado restaurar el habla en personas con parálisis severa mediante modelos de IA personalizados que requieren decenas de horas de datos cerebrales. Sin embargo, Brain-IT se distingue al reconocer patrones compartidos entre todos los cerebros, lo que reduce drásticamente el tiempo de entrenamiento. Mientras otros sistemas necesitan muchas horas de escaneo para adaptarse a un sujeto, Brain-IT solo necesita una hora.
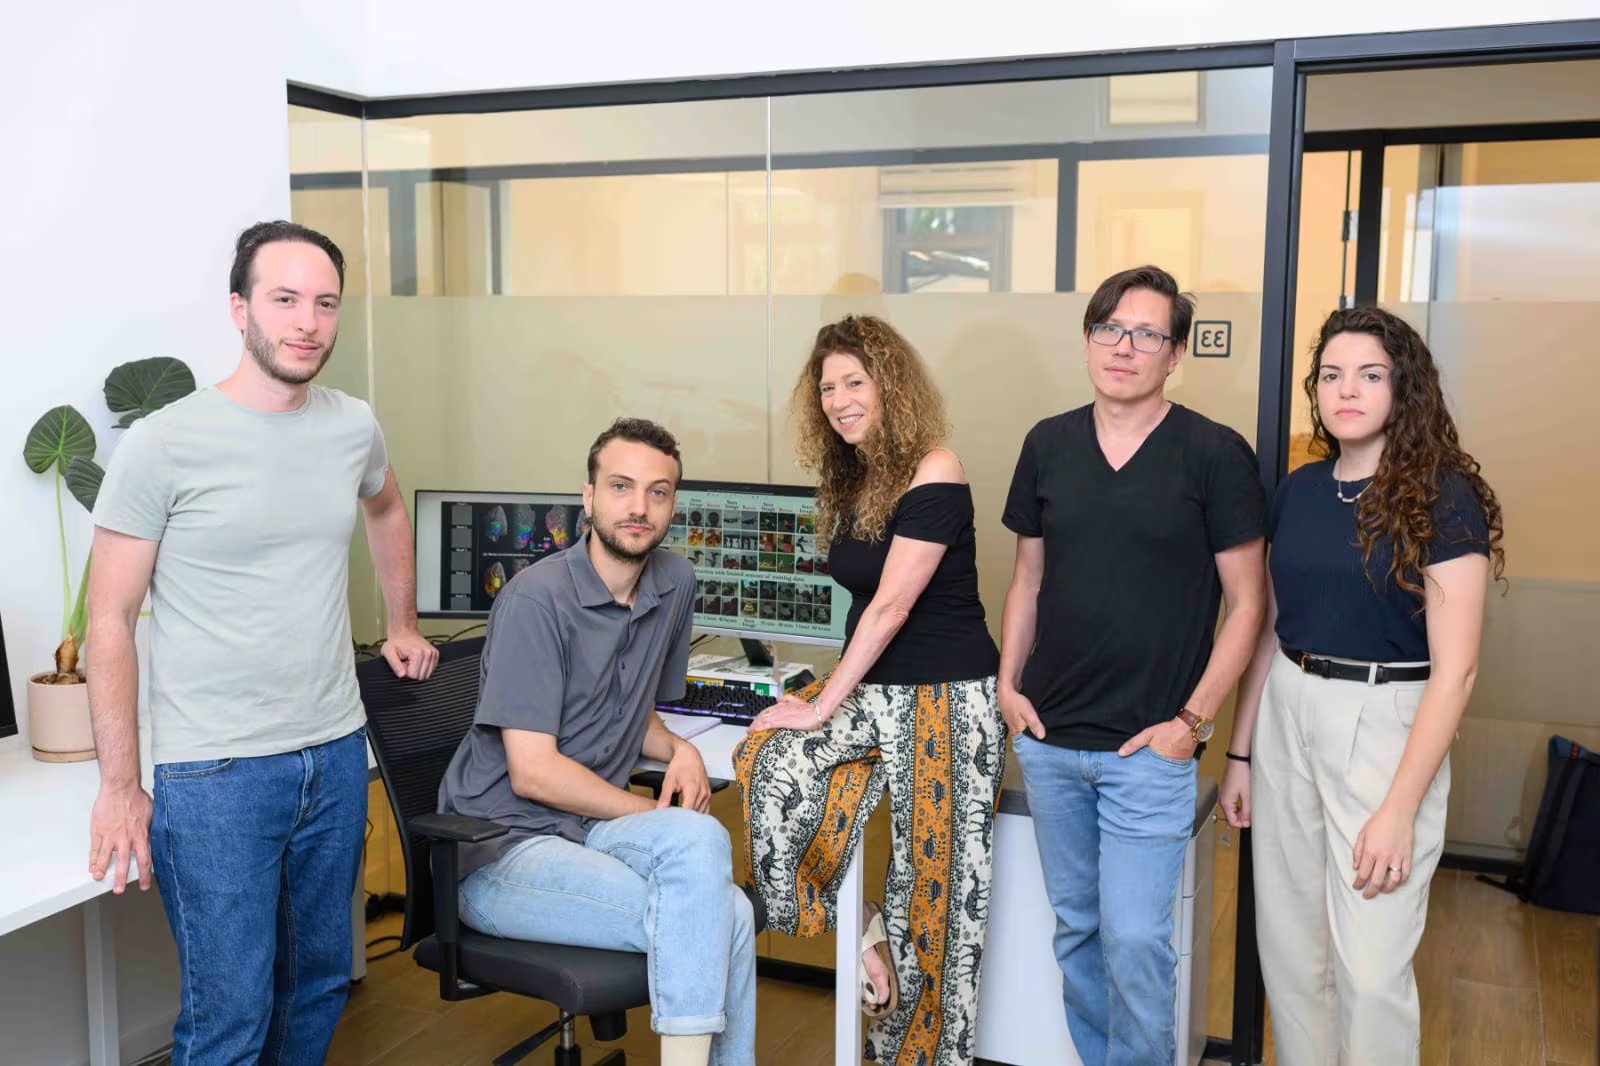
“Hoy en día existen modelos que traducen la actividad cerebral en imágenes, e incluso pueden producir reconstrucciones impresionantes que preservan razonablemente bien el significado semántico de la imagen”, afirma Irani. “Sin embargo, tienden a cometer errores en características básicas, como la composición y el color. El nuevo modelo que desarrollamos los supera en la reconstrucción tanto del contenido de la imagen como de sus detalles. Además, mientras que cualquier otro modelo requiere decenas de horas de escáneres cerebrales para aprender a leer a una nueva persona, nuestro modelo necesita solo una hora”.
El desarrollo de Brain-IT, que este año fue seleccionado para presentarse en la Conferencia Internacional sobre Representaciones de Aprendizaje (ICLR), no estuvo exento de desafíos. El equipo de la profesora Irani, perteneciente al Departamento de Ciencias de la Computación y Matemáticas Aplicadas, se enfrentó a una escasez crítica de datos. Entrenar un modelo de IA de este tipo requiere una enorme cantidad de imágenes apareadas con exploraciones de resonancia magnética funcional (fMRI) de la actividad cerebral. Sin embargo, la recolección de estos datos es compleja, ya que los participantes deben permanecer largos períodos dentro de las máquinas de resonancia. Como resultado, el mayor conjunto de datos disponible contiene exploraciones de fMRI de solo ocho individuos, cada uno observando algunos miles de imágenes, una cantidad insuficiente para el entrenamiento de algoritmos de IA.
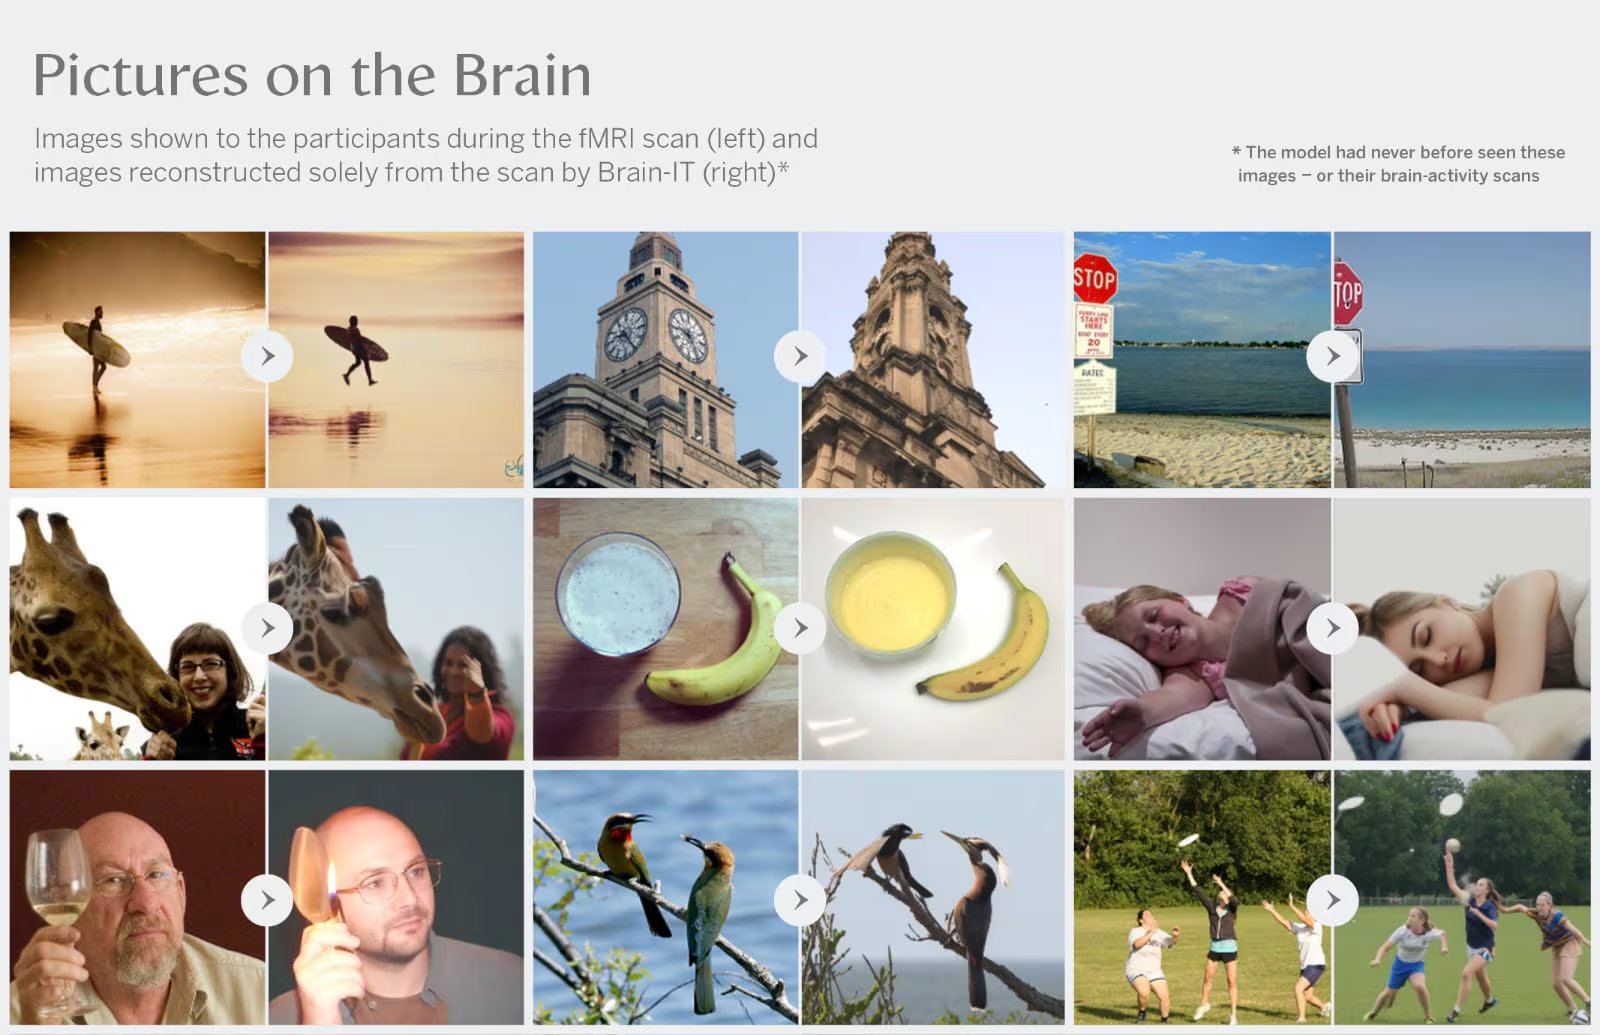
Para superar esta limitación, Irani y su equipo idearon una solución similar a un diccionario bilingüe bidireccional. En lugar de un simple decodificador que reconstruye una imagen a partir de una fMRI, crearon también un codificador que predice una exploración de fMRI a partir de una imagen. Este enfoque generó un círculo virtuoso de traducción.
“Nos dimos cuenta de que, al traducir de un lado a otro —desde una imagen aleatoria que nunca había sido vista en una máquina de fMRI, a una exploración cerebral predicha y luego de vuelta a la imagen con la que empezamos—, los modelos construirían de hecho por sí mismos un enorme conjunto de datos”, explica Irani.
“El plan era alimentar al codificador con imágenes que nunca se habían mostrado a una persona en un escáner de resonancia magnética, generar para ellas exploraciones cerebrales estimadas y pasar esas exploraciones al decodificador, que intentaría reconstruir a partir de ellas la imagen original. De esta manera, durante el entrenamiento, los modelos aprenderían a generar exploraciones que codificaran las imágenes de forma eficaz, aunque esas exploraciones de fMRI nunca se hubieran realizado realmente”.
El mayor reto fue la variación entre cerebros individuales: una misma imagen puede activar patrones diferentes en distintas personas. La solución consistió en descomponer el problema. En lugar de codificar una imagen en una fMRI completa, los investigadores dividieron el cerebro en aproximadamente 40.000 “vóxeles cerebrales” (unidades tridimensionales de volumen) y midieron la respuesta de cada vóxel a distintas imágenes. Paralelamente, un modelo de IA extrajo de las imágenes características visuales básicas (color, ubicación) y semánticas (significado, como alimento o rostro). A este nivel de detalle, surgieron patrones de actividad que se repetían en distintos cerebros, asociados a características específicas de las imágenes, lo que permitió construir un codificador cerebral universal.
El camino hacia la lectura de la mente
El codificador cerebral resultó mucho más que una herramienta técnica. “Durante el entrenamiento, el codificador identificó de forma natural 128 regiones funcionales que son compartidas por todas las personas y desempeñan funciones específicas en el procesamiento de imágenes”, detalla Irani. “Algunas de ellas son conocidas por los neurocientíficos, pero otras son completamente nuevas. Por ejemplo, descubrimos una división de funciones dentro de la región cerebral que procesa imágenes de lugares —la PPA—, con una parte que responde a escenas de interiores y otra a escenas de exteriores”.
“La fortaleza del codificador reside en su capacidad de identificar regiones que desempeñan funciones similares en distintos cerebros, incluso cuando sus ubicaciones anatómicas difieren”, añade Irani.
“Otra ventaja es su capacidad para probar diferentes características de manera controlada. Por ejemplo, se le puede proporcionar la misma imagen en color y en blanco y negro, identificar las diferencias entre las exploraciones de fMRI predichas y, a partir de ello, inferir dónde se codifica el color en el cerebro. En el futuro, el codificador también podría ayudarnos a comprender cómo trabajan juntas diferentes regiones y cómo toma forma la percepción”.
El laboratorio de Irani ya trabaja en extender estos métodos a la decodificación de información auditiva. El video es otra frontera. “Lo que sigue siendo especialmente desafiante es decodificar video, por ejemplo, durante los sueños”, comenta Irani. “Decenas de imágenes cambian cada segundo, mientras que una exploración de fMRI tarda unos dos segundos. Si superamos todos estos obstáculos, es posible que en el futuro incluso podamos leer los sueños”.
Fuente: Infobae