Un equipo internacional de investigadores ha logrado que una inteligencia artificial genere imágenes panorámicas realistas para el turismo virtual a partir de simples descripciones de texto. El sistema, denominado SGMSD-Net, produce escenas completas en alta resolución con una calidad visual y una coherencia semántica superiores a las de los modelos existentes, según detalla el estudio publicado en la International Journal of Information Quality.
La investigación está liderada por Lun Wei, profesora de la Universidad de Ma’anshan, en la provincia china de Anhui. El trabajo aborda una debilidad común en los generadores actuales: la tendencia a crear imágenes visualmente parecidas entre sí, sin capturar con fidelidad el significado semántico de la escena solicitada. Para resolverlo, SGMSD-Net combina una guía semántica explícita con un proceso de difusión estructurado en múltiples escalas de resolución.
Tres fases progresivas: del diseño global al detalle de textura
El funcionamiento del modelo se organiza en tres etapas sucesivas. En la primera, el sistema establece la distribución espacial general y los colores de la escena. En la segunda, refina los bordes de los objetos y las estructuras. En la tercera y última, restituye texturas, patrones de iluminación y detalles de alta frecuencia. Este esquema permite que cada nivel del proceso se concentre en un tipo específico de información visual, en lugar de intentar optimizar todos los aspectos de una imagen de alta resolución en una única pasada.
El componente semántico funciona mediante un módulo de codificación que convierte etiquetas textuales —como la categoría de la escena, el tipo de monumento o la condición climática— en vectores numéricos. Esos vectores generan parámetros de modulación que actúan directamente sobre las capas intermedias de la red neuronal a través de un mecanismo llamado FiLM (Feature-wise Linear Modulation). De esta forma, el modelo ajusta la escala y el desplazamiento de las características visuales según el significado semántico de la descripción recibida.
Pruebas con dos conjuntos de datos muestran mejoras en todos los indicadores
Los experimentos se realizaron con SUN360, una base de datos que contiene más de 26.000 imágenes panorámicas de interiores y exteriores, y con Matterport3D, que reúne más de 10.000 puntos de vista de 90 entornos arquitectónicos tridimensionales reales.
En ambos conjuntos, SGMSD-Net superó a cuatro modelos de referencia —Pix2PixHD, SPADE, DDPM y Stable Diffusion— en los tres indicadores empleados: FID (similitud de distribución con imágenes reales), LPIPS (consistencia perceptiva) y CLIP Score (alineación entre imagen y descripción).
El modelo alcanzó una puntuación media de 9 sobre 10 en la evaluación subjetiva realizada por diez voluntarios, quienes calificaron las imágenes generadas en claridad, realismo y coherencia semántica. En el indicador de Precisión de Atributo Semántico (SAA), el sistema obtuvo un promedio de 92,9 %, superando en 5,9 puntos porcentuales al segundo mejor modelo evaluado.
La arquitectura de tres etapas demuestra su superioridad en experimentos de ablación
Para verificar que la mejora de rendimiento proviene del diseño jerárquico y no del aumento de parámetros, el equipo realizó un experimento de ablación en el que varió el número de etapas de difusión, manteniendo constantes los demás componentes. Los resultados mostraron que la arquitectura de tres etapas reduce el FID en un 20,8 % respecto al modelo de una sola etapa en SUN360, y en un 21,7 % en Matterport3D, mientras que el CLIP Score sube 2,4 % y 2,8 % respectivamente.
En cuanto al costo computacional, el sistema requiere 356,2 millones de parámetros y 10,3 segundos por imagen, cifras que se ubican entre las del modelo DDPM —más liviano, pero menos preciso— y Stable Diffusion —más grande y lento—. El consumo de memoria GPU es de 13,9 gigabytes, frente a los 15,8 que demanda Stable Diffusion.
Patrimonio cultural, museos y planificación urbana: las aplicaciones potenciales
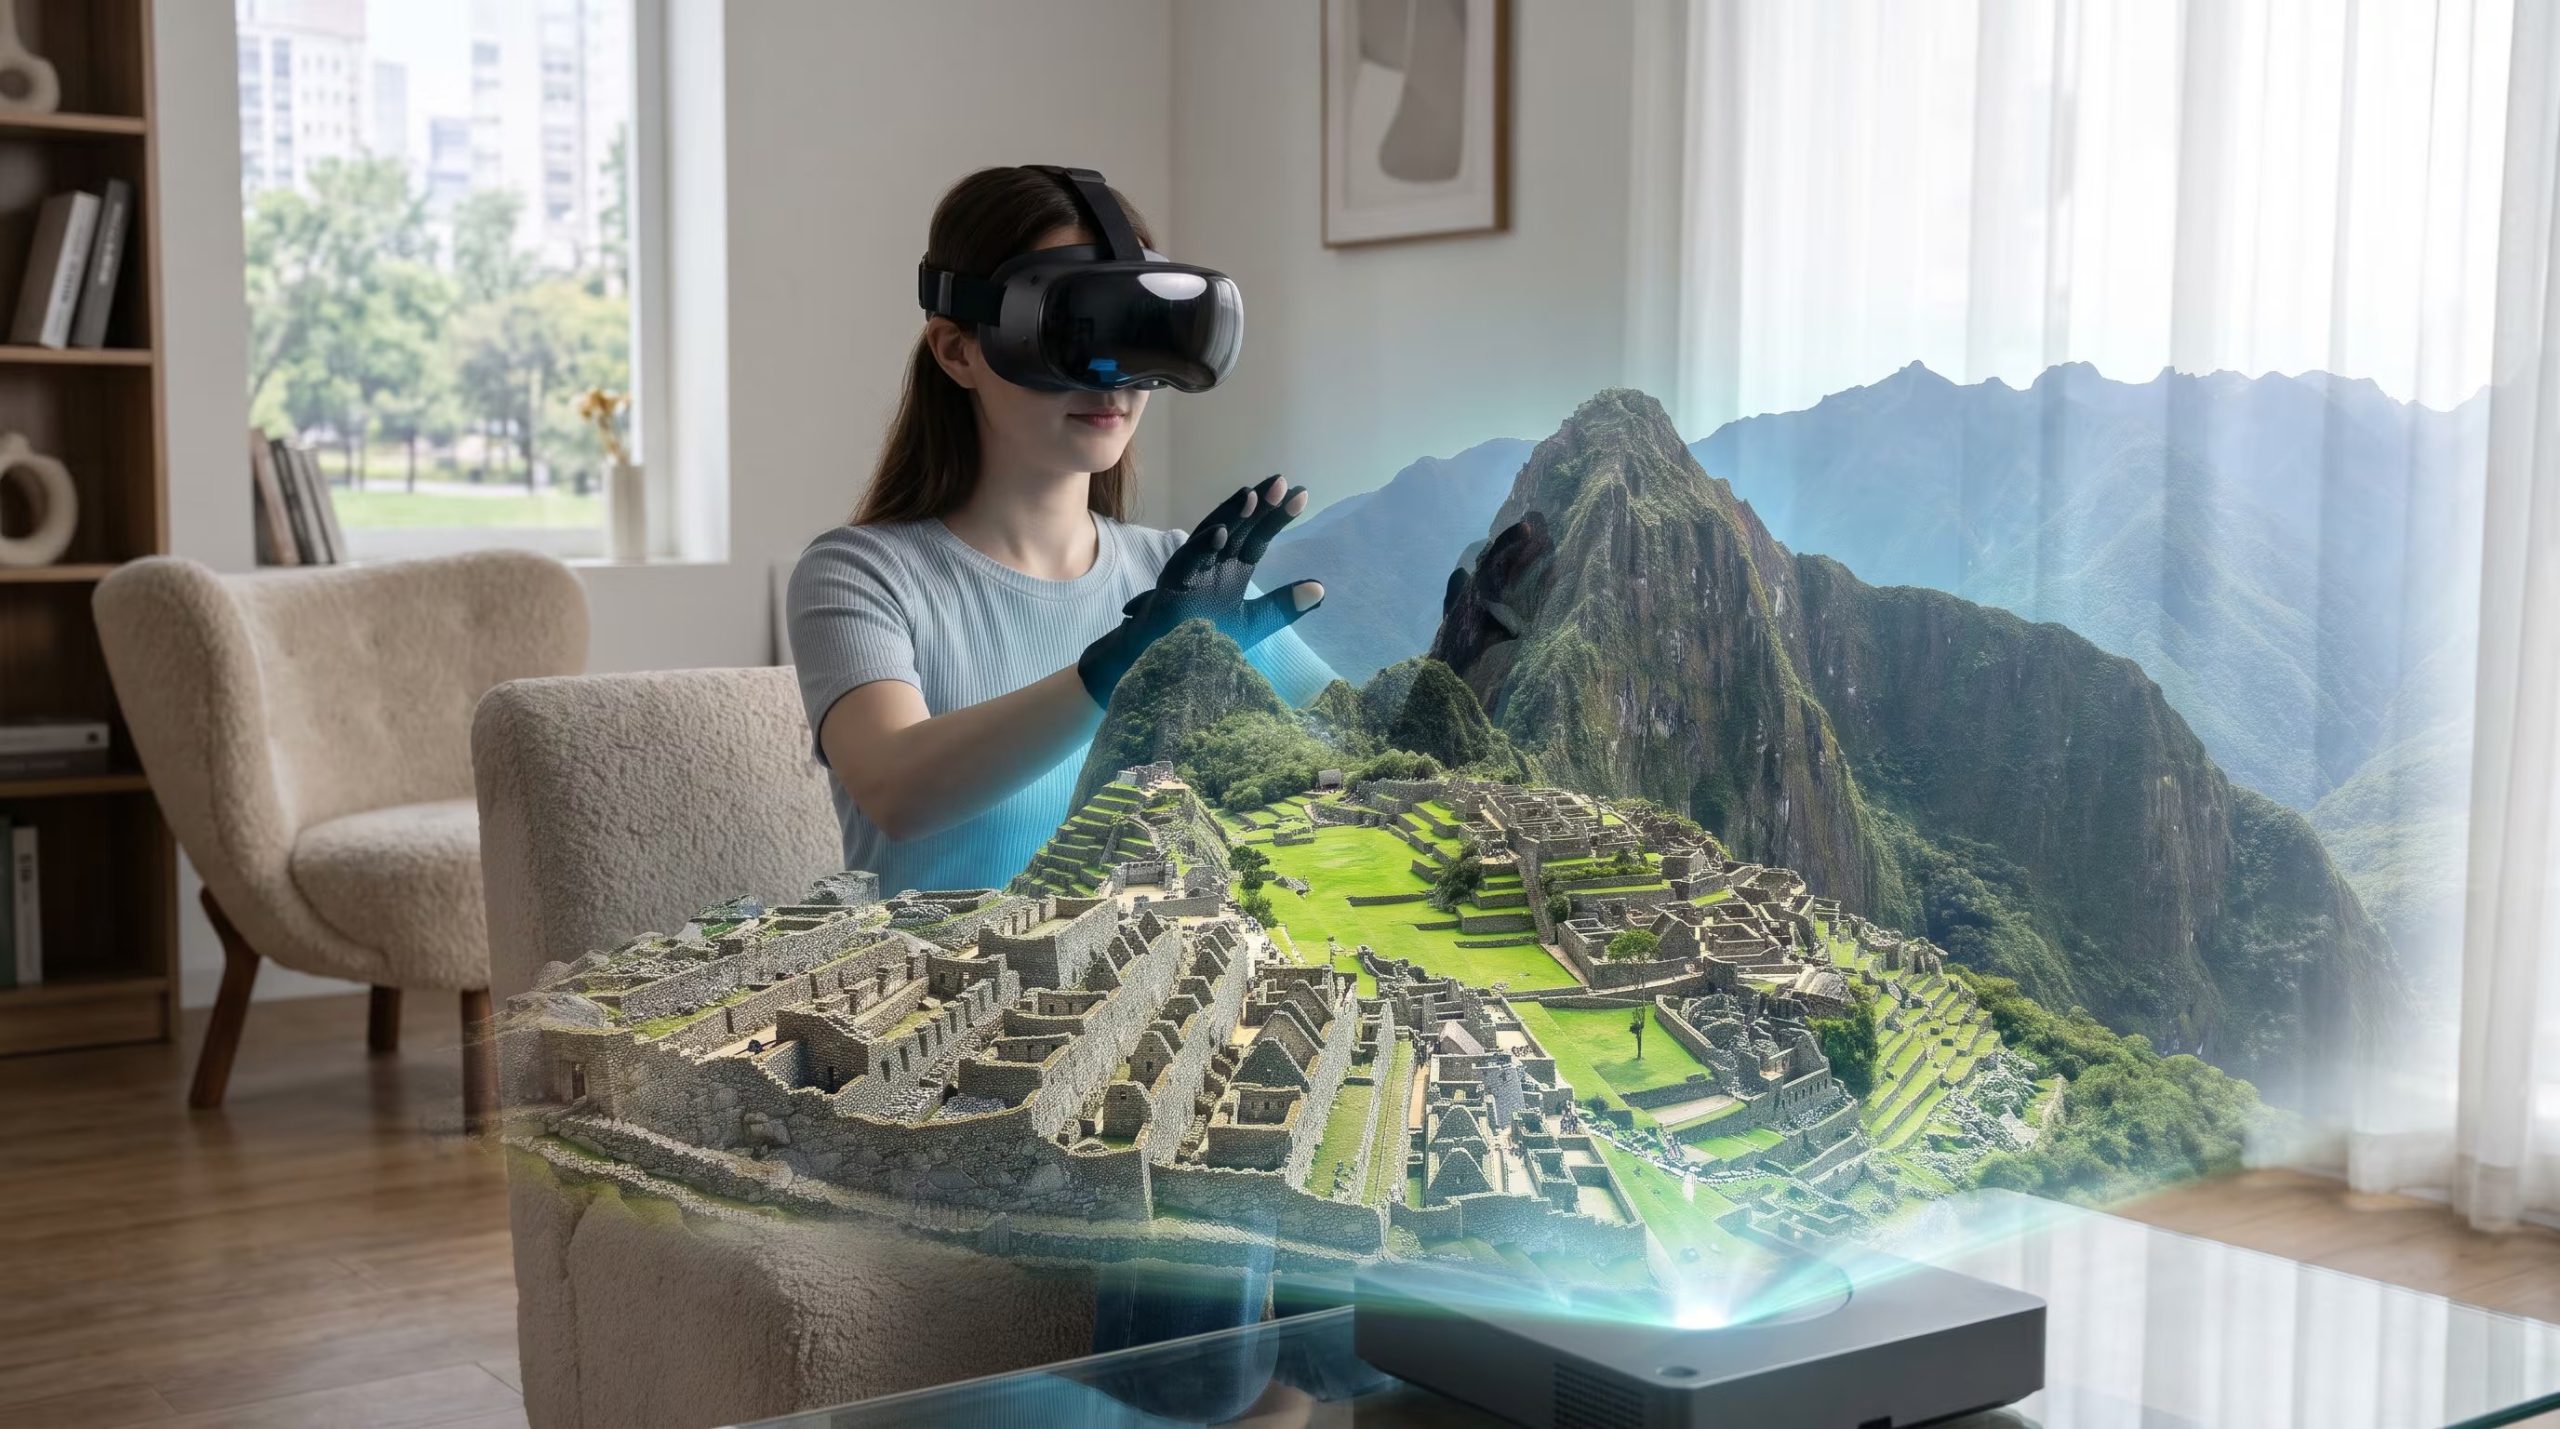
El estudio identifica como aplicaciones potenciales la producción de recorridos virtuales de destinos turísticos antes del viaje, la visualización educativa de sitios históricos de difícil acceso y la generación de contenido para exposiciones y diseño de exhibiciones. Los autores también señalan la posibilidad de integrar las imágenes generadas con sistemas de realidad virtual y aumentada.
El equipo reconoce limitaciones en la cobertura geográfica y cultural de los conjuntos de datos utilizados, así como en el desempeño bajo condiciones de iluminación extremas o estructuras espaciales muy complejas. El modelo también depende de etiquetas semánticas predefinidas, lo que reduce su capacidad para interpretar descripciones libres o ambiguas. Como próximos pasos, los investigadores plantean integrar modelos multimodales preentrenados de mayor escala y explorar mecanismos que combinen la guía semántica por atributos con interacción en lenguaje natural.
Fuente: Infobae