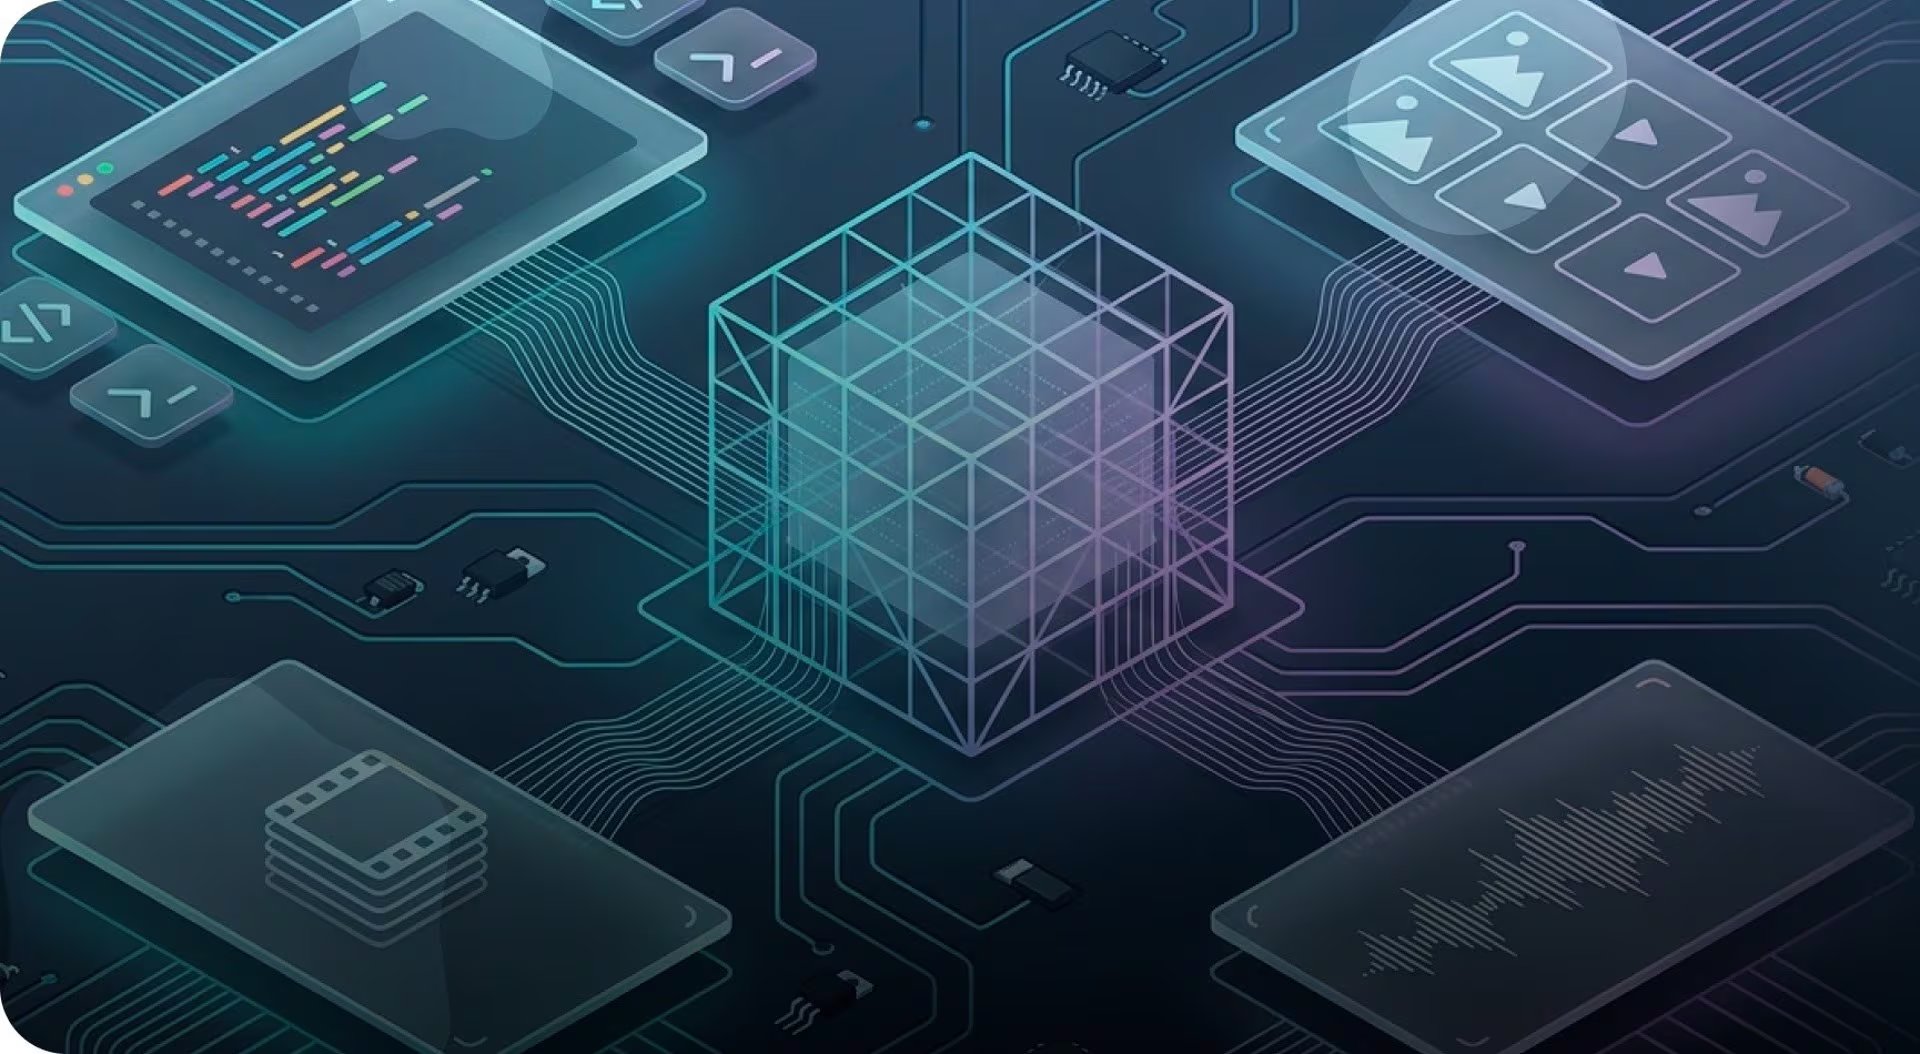
La división de inteligencia artificial de Google, DeepMind, ha puesto a disposición de los desarrolladores su más reciente creación: EmbeddingGemma 2. Este modelo de pesos abiertos destaca no solo por su reducido tamaño, que permite instalarlo en un teléfono inteligente, sino también por su capacidad de incrustación multimodal. Es decir, puede convertir distintos tipos de información —como texto, imágenes, video y audio— en vectores numéricos dentro de un mismo sistema.
La compañía compartió los detalles de EmbeddingGemma 2, calificándolo como el mejor de su clase por su ligereza y los pocos recursos de cómputo que requiere. Los desarrolladores pueden probarlo en un móvil Android o iPhone mediante la aplicación Google AI Edge Gallery, que incluye dos demostraciones: la búsqueda instantánea de contenido sin conexión y el Video Moments Finder.
Búsqueda local en tiempo real
La búsqueda instantánea de contenido permite organizar y localizar fotos y videos de forma local, en tiempo real, a medida que se escriben las palabras. Funciona relacionando frases o imágenes de ejemplo con los vectores de las fotos almacenadas en una base de datos SQLite, guardada directamente en el dispositivo.
Video Moments Finder
La segunda demostración sin conexión, Video Moments Finder, es capaz de encontrar fotogramas concretos dentro de videos locales con frases como “niños riéndose” o “perro atrapando una pelota de tenis”. Lo hace analizando la imagen y fragmentos de audio, sin necesidad de generar transcripciones de texto intermedias.
Además de estas opciones para móviles, Google también ha preparado una demostración para Mac: la aplicación experimental Google AI Edge Foresight. Actúa como un asistente de reuniones local y privado, conectándose al audio del sistema y al micrófono para funcionar sin conexión con cualquier plataforma de videollamadas.
Estos ejemplos reflejan la utilidad que EmbeddingGemma 2 ofrece a los desarrolladores. Su función principal es representar texto, imágenes, fotogramas de video y audio en un único espacio vectorial numérico, lo que permite relacionar y buscar cualquier tipo de archivo sin necesidad de traducirlo primero a texto.
El modelo se caracteriza por su tamaño compacto de 740 millones de parámetros. Está diseñado para ejecutarse localmente en el dispositivo, sin conexión a internet, garantizando así la privacidad de los datos. Esto abre la puerta a que los desarrolladores integren estas funciones de búsqueda en nuevas aplicaciones o en futuras actualizaciones.
Para facilitar la integración, Google ha puesto a disposición varias herramientas, entre ellas ML Kit (que llegará en las próximas semanas), MediaPipe Tasks y LiteRT.
Fuente: Infobae