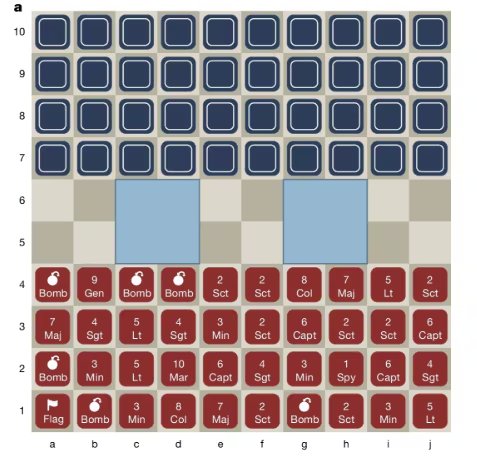
Un equipo de investigadores del Instituto Tecnológico de Massachusetts (MIT), junto con Carnegie Mellon, Stanford y la Universidad de Nueva York, ha desarrollado un sistema de inteligencia artificial que logró derrotar por primera vez al mejor jugador humano de Stratego. Este juego de guerra de mesa, caracterizado por piezas ocultas, había resistido todos los intentos anteriores de automatización.
El sistema, bautizado como Ataraxos, se enfrentó al neerlandés Pim Niemeijer, considerado el jugador más laureado en la historia de Stratego. En una serie de 20 partidas, Ataraxos obtuvo 15 victorias, 1 derrota y 4 empates. Los resultados fueron publicados en la prestigiosa revista Nature.
El costo que marca la diferencia
Lo que realmente distingue a Ataraxos de intentos previos no es solo su desempeño, sino el costo de entrenamiento. Según el estudio, entrenar el sistema demandó menos de USD 8,000: una semana utilizando 16 procesadores gráficos Nvidia H100, más cuatro días adicionales con otros cuatro procesadores para entrenar una red que calcula las jugadas probables del rival.
La comparación directa es con DeepNash, el sistema que Google DeepMind presentó en 2022. DeepNash se entrenó durante dos o tres meses sobre 1,024 nodos de TPU, los procesadores especializados de la compañía. Los autores del nuevo estudio estiman que ese entrenamiento costaría entre USD 3,000,000 y USD 4,500,000 a precios actuales. DeepNash logró ubicarse entre los tres mejores jugadores de la plataforma Gravon en 2022, pero nunca superó de forma sostenida a los humanos de élite. En contraste, Ataraxos sumó un historial de 39 victorias y 2 derrotas frente a jugadores de primer nivel en el campeonato mundial de Stratego, además del resultado contra Niemeijer.
La complejidad de Stratego frente al ajedrez
A diferencia del ajedrez o del Go, donde ambos jugadores ven el tablero completo, en Stratego cada bando conoce la posición de las 40 piezas rivales pero no su identidad. Esa información oculta multiplica las combinaciones posibles y había frenado durante años cualquier intento de lograr un desempeño sobrehumano.
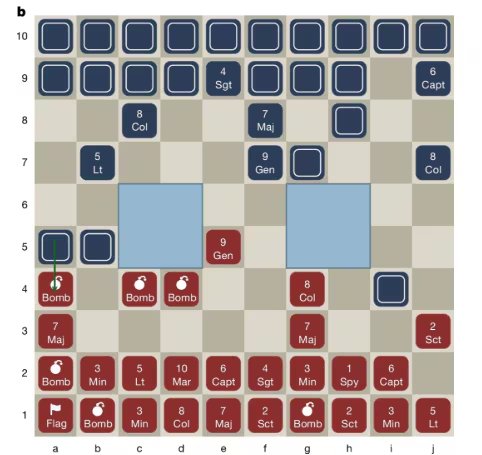
“Con Stratego hay una explosión de universos posibles con los que hay que lidiar. Las técnicas de IA que se desarrollaron para juegos como el póker no podían escalar en este entorno”
explicó Gabriele Farina, profesor asistente del MIT y uno de los autores del trabajo, a MIT News.
Para resolver este desafío, el equipo combinó aprendizaje por refuerzo —una técnica en la que el sistema aprende jugando contra sí mismo millones de veces— con una red de creencias que estima, en cada turno, cuál es la configuración más probable del tablero rival.
“En lugar de adivinar a ciegas, usamos planificación en el momento de decidir para encontrar el estado más plausible del tablero”
agregó Farina.
Estrategia impredecible y manejo del riesgo
El diseño de Ataraxos también buscó evitar que se volviera predecible. Durante el entrenamiento, los investigadores presionaron al modelo para que variara sus configuraciones y movimientos en lugar de fijar una estrategia temprana. En Stratego, esto es crucial porque los jugadores predecibles terminan siendo explotados por el rival.
Farina también destacó la forma en que el sistema administra el riesgo frente a un humano.
“Ataraxos calcula el riesgo de una manera que los humanos no. Una persona puede alarmarse si su pieza más valiosa queda expuesta, pero el sistema puede mantenerse sorprendentemente sereno: no sobrecorrige ni delata sus secretos”
señaló el investigador.
La serie contra Niemeijer se extendió durante tres semanas, lo que le dio al jugador neerlandés tiempo para estudiar al rival entre partida y partida y buscar debilidades. Aun así, no pudo superar a la máquina.
Los mismos autores aplicaron la técnica a otros juegos con información oculta. Lograron el primer resultado sobrehumano documentado en Barrage Stratego, una variante más rápida y con menos piezas, derrotando a tres campeones mundiales de esa modalidad. También alcanzaron nuevos récords en el juego cooperativo Hanabi y superaron a los sistemas de referencia existentes en dou dizhu, un juego de cartas chino.
Los investigadores plantearon que el método podría extenderse a problemas del mundo real donde la información está repartida de forma desigual entre las partes, como negociaciones comerciales, simulaciones de ciberseguridad o planificación militar, siempre que se pueda construir un simulador rápido y preciso del escenario.
El equipo señaló que su próximo paso es incorporar mecanismos de interpretabilidad al sistema, de forma que Ataraxos pueda explicar sus decisiones en un lenguaje comprensible para las personas que deban supervisar o validar sus recomendaciones.
Fuente: Infobae